国外
01 / 头条
Gemini 4 Carbon 先面向网络安全防御者
Google 于10月28日宣布 Gemini 4 Carbon,本周先向部分网络安全防御者开放,再通过 Fairwind 计划扩大可信伙伴范围。面向普通开发者、企业和消费者的上线日期尚未公布。
Google 将 Carbon 定位为更擅长长时间工程任务和网络安全防御的新模型。公告描述了发现漏洞、验证风险和修复根因的能力,并披露内部团队观察到它能连续处理多天的工程任务;这些效果来自厂商评测与使用观察。
开放采用分阶段方式:先给部分网络安全防御者使用,再增加可信伙伴。公告列出的介绍期价格是每百万输入 token 2美元、输出10美元,介绍期结束后分别为4美元、20美元;普通用户入口和明确上线日期未公布。
原始来源:Google DeepMind ↗
02 / 国外
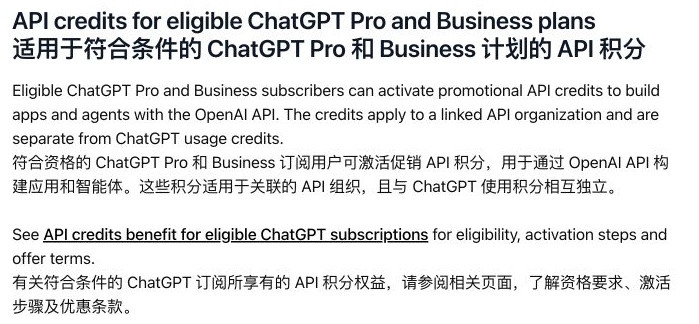
部分 ChatGPT 订阅 可领取 API 额度
OpenAI 为符合条件、付费至少7天的 Pro 和 Business 订阅提供可激活的 API 赠送额度。Plus 不适用,领取人须满足订阅与 API 组织的所有者要求,且使用相同邮箱。
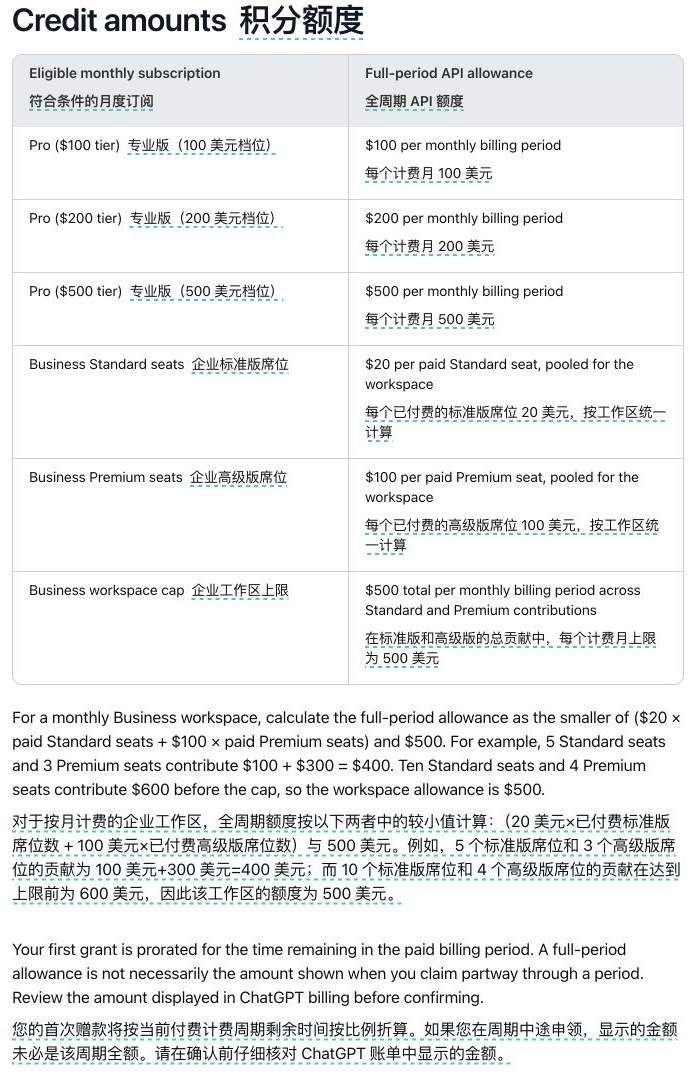
Pro 100、200、500美元档的完整月周期额度分别为100、200、500美元。月付 Business 按每个 Standard 付费席位20美元、Premium席位100美元合计,每周期最高500美元;年付预付工作区一次发放全年额度,最高6000美元。首期按剩余付费周期折算,未用完的额度到期失效。
领取需关联一个 API 组织,并检查实际到账。额度用于该组织符合范围的 API 消费,不增加 ChatGPT 或登录式 Codex 用量,也不覆盖以 API key 使用 Codex。开放还受地区和获邀批次影响。
原始来源:OpenAI ↗
03 / 国外
Gemini 互动探索 学习场景可以点开看
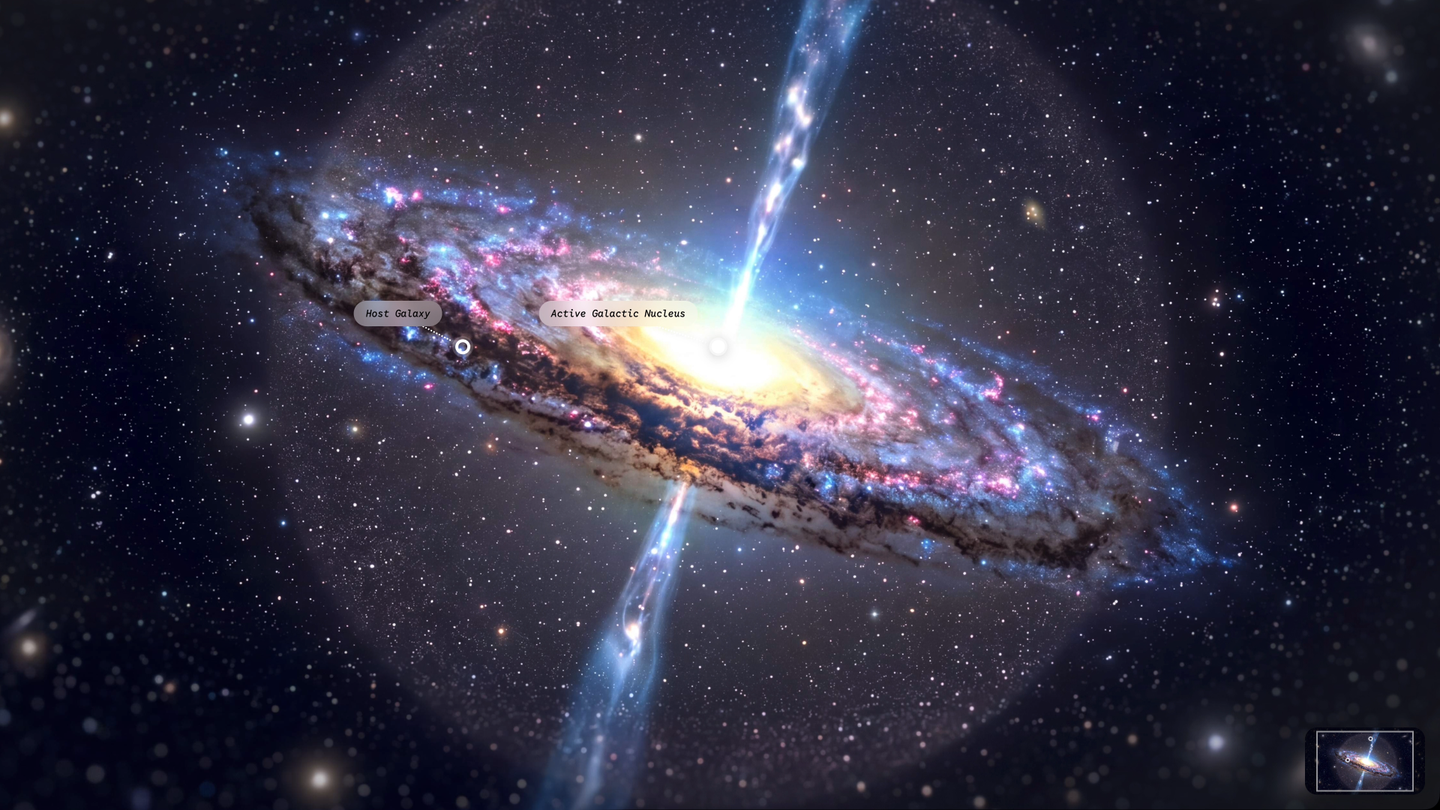
Google 在 Gemini 学生学习中心上线互动探索库,用户可逐层操作喷气发动机、行星和原子等场景。功能支持简体中文,聊天内访问和音频讲解仍是后续计划。
Google 10月28日公告称,用户可在学生学习中心点击“Try immersive explorations”,通过标签逐层查看结构和知识点。官方举例包括丝绸之路贸易路线、喷气发动机内部和闪电物理。
现已支持英语、印度尼西亚语、印地语、巴西葡萄牙语、法语和简体中文,其他语言用户目前获得英语体验。直接在 Gemini 聊天中访问这些探索,以及逐层音频讲解,将在后续加入。
原始来源:Google ↗
04 / 国外
Gemini Notebook 手机录音直接变资料
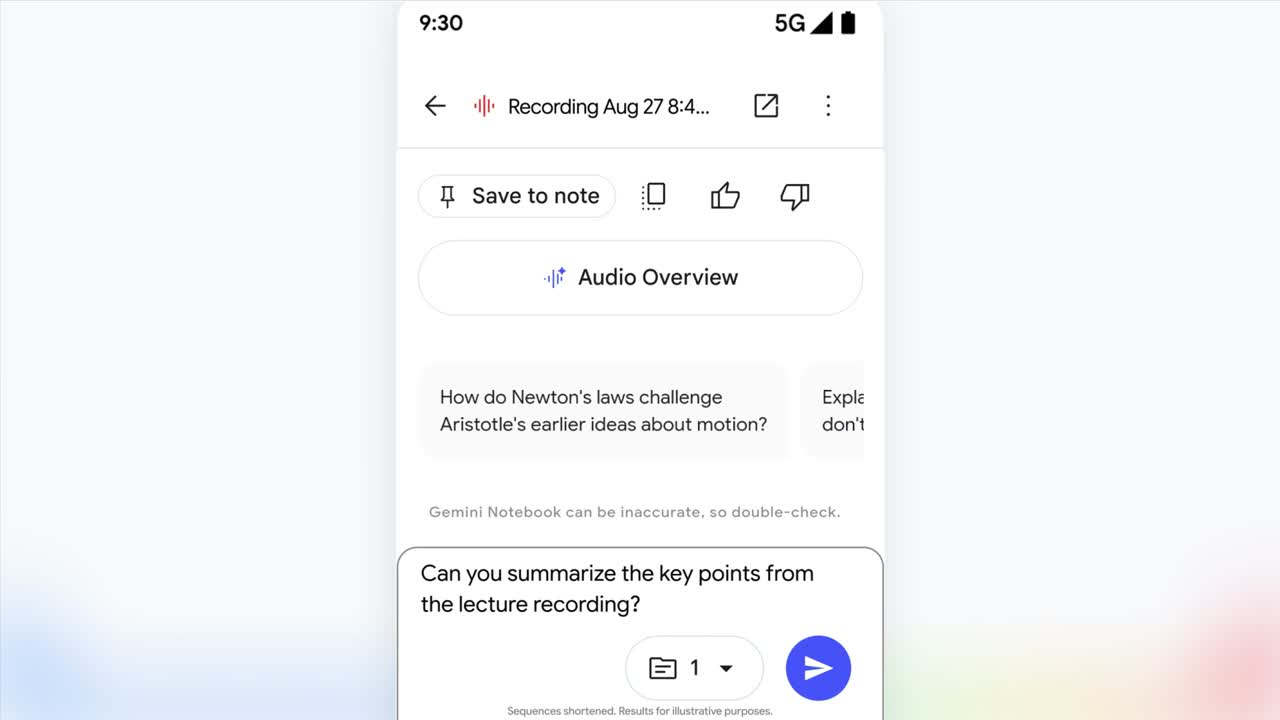
Gemini Notebook 官方宣布,手机应用可录制最长一小时现场音频,并直接作为资料来源;官方回复确认 iOS 与 Android 用户均可使用。
官方在10月27日的帖子中介绍了现场录音功能,举例包括讲座和团队会议。录音完成后可直接作为 Notebook 的来源使用,减少先用另一款录音工具保存、再导入的步骤。
官方还建议把录音与手写笔记照片组合成个人工作空间。本条依据官方主帖和平台范围回复,不包含第三方关于 Google Drive 连接器的其他线索。
05 / 国外
Copilot 集中更新 选模型、做项目、操作电脑
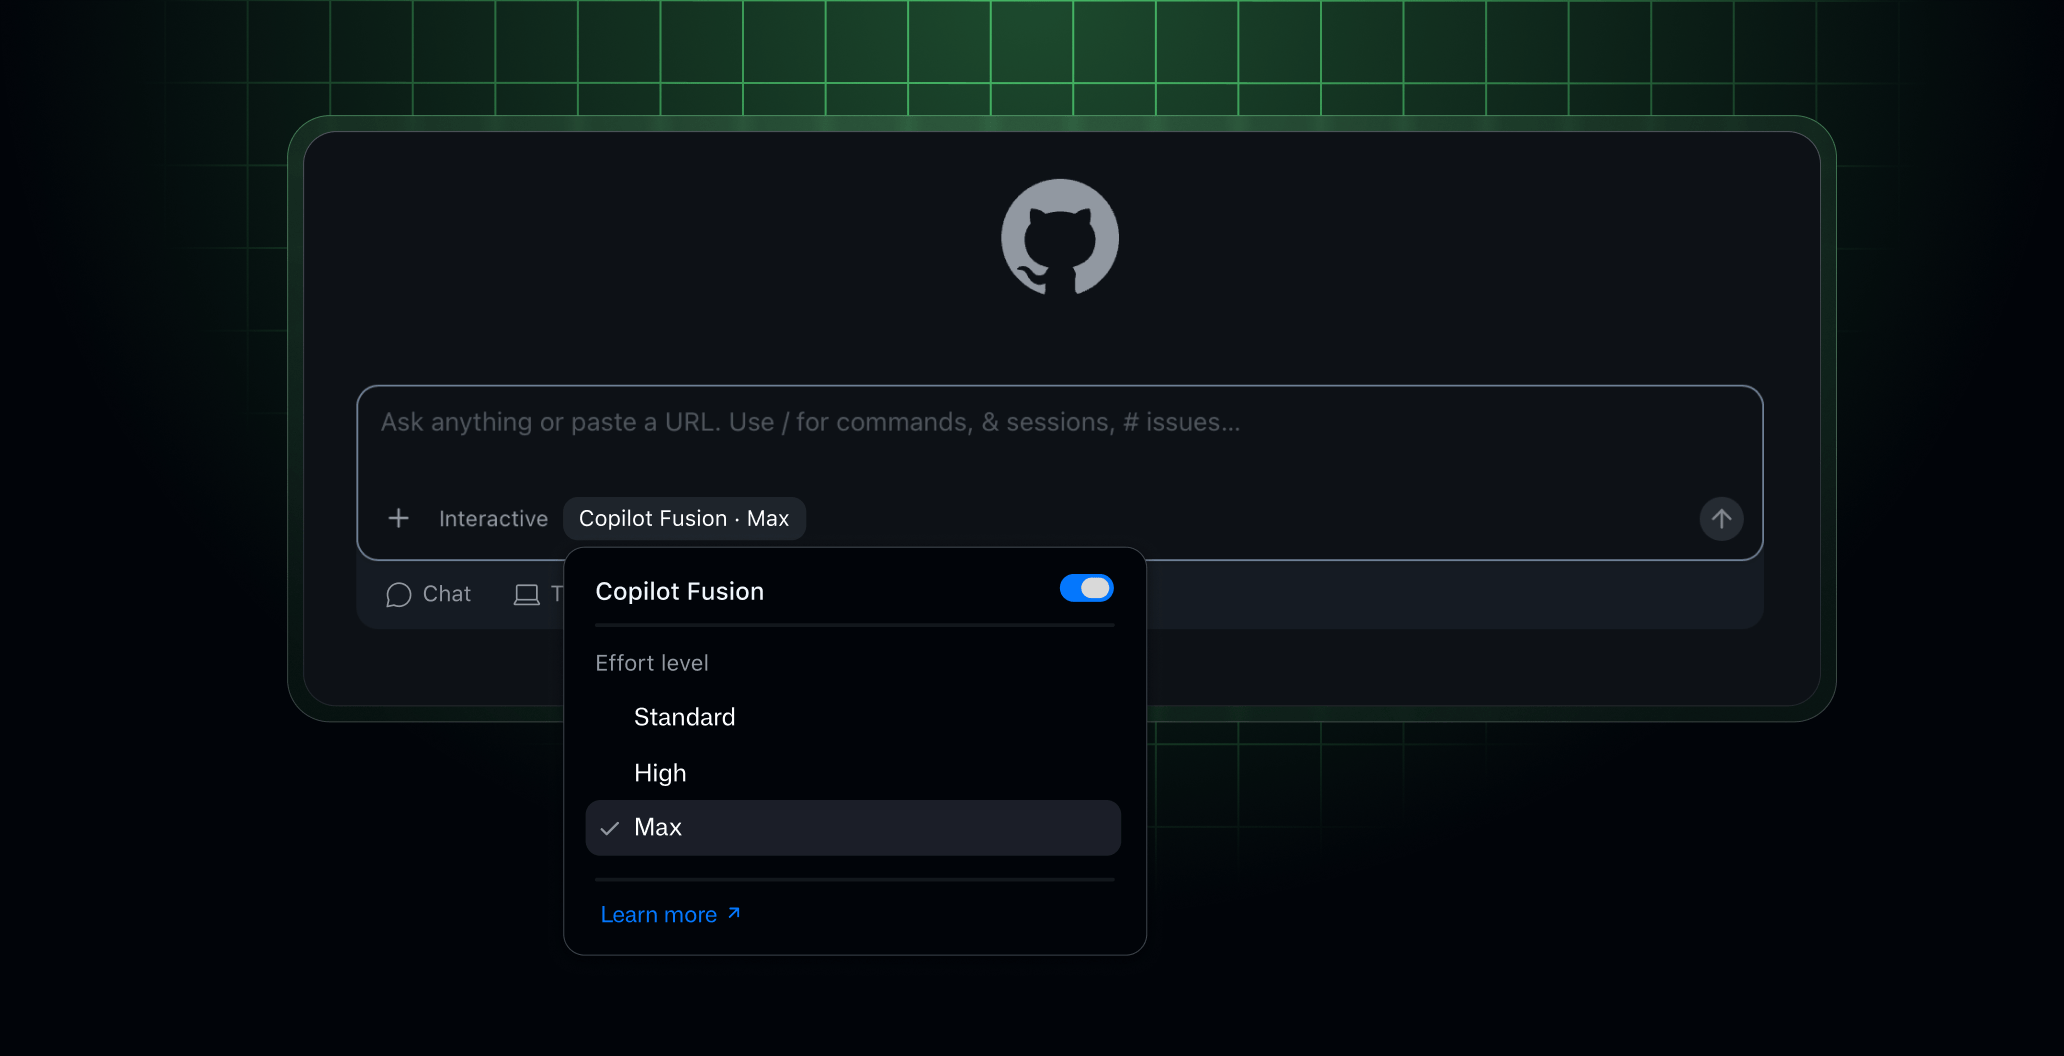
GitHub 正式推出 Copilot Fusion,按任务选择或组合模型;Copilot App 的 Projects 和 macOS、Windows 电脑操作进入公开预览,聊天内图片生成与编辑也在公开预览中。
Fusion 提供 Standard、High、Max 三档投入程度,可让单模型完成任务,或采用初稿检查后升级、另一模型审稿后修改等组合流程。它已覆盖所有 Copilot 计划,在 VS Code、Copilot App、CLI 和 JetBrains 中提供。费用按实际调用模型计算,付费计划的模型费用限时七折。
Projects 可以把仓库、设计和说明放在同一个项目里,由多个代理协作。电脑操作预览支持 macOS 和 Windows,控制应用前会请求授权。图片生成由专用图像工具处理,面向 Pro、Pro+、Business 和 Enterprise 公开预览,图像 token 与聊天模型分别计费。
原始来源:GitHub ↗
06 / 国外
HeyGen Voice STS 把声音表演带给数字人
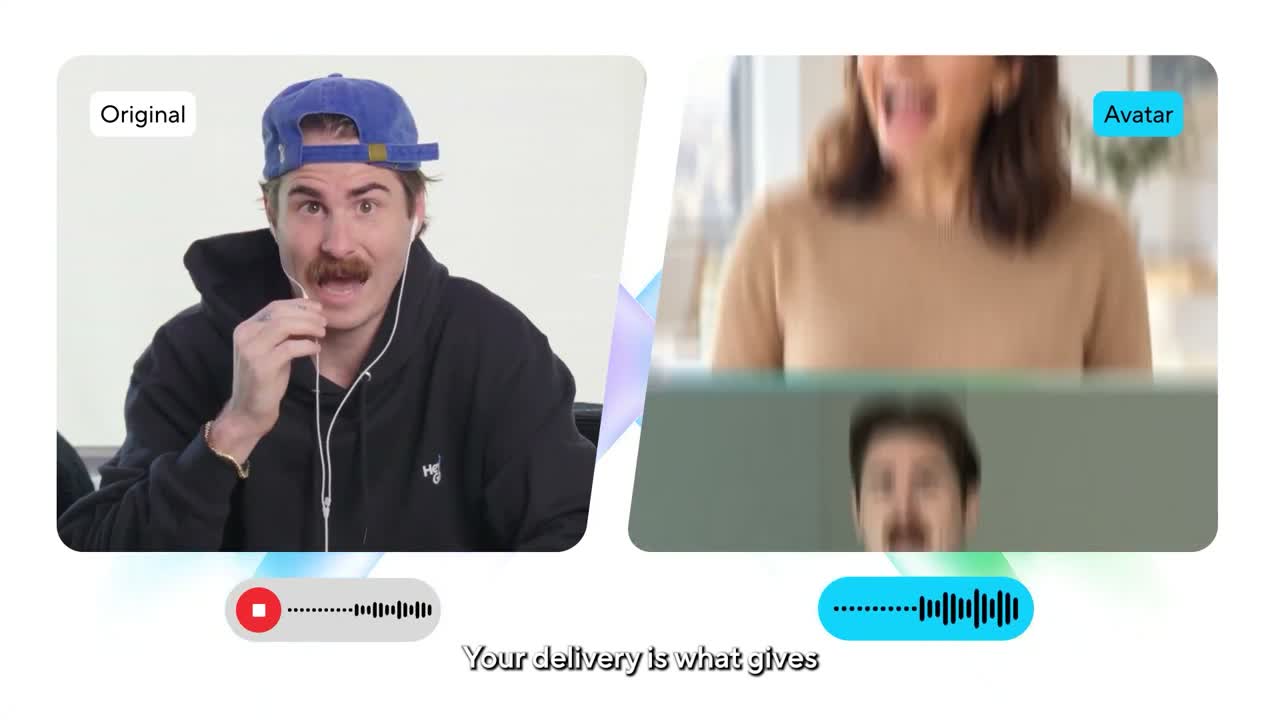
HeyGen 宣布 Voice STS 语音到语音功能,提供体验入口。官方称它可以把用户的声音表演传递给数字人,包括停顿、强调和轻声表达。
HeyGen 于10月28日发布演示,主张由用户先说一次,再把整段表演带给数字人。相比只提交文字,输入声音能够携带说话节奏与表达方式。
官方回复给出了15秒录音约5秒、1分钟录音不到10秒的处理例子。本期展示的是官方演示,未对所有音频长度、网络和任务条件下的速度与保真度作产品实测。
原始来源:HeyGen ↗
07 / 国外
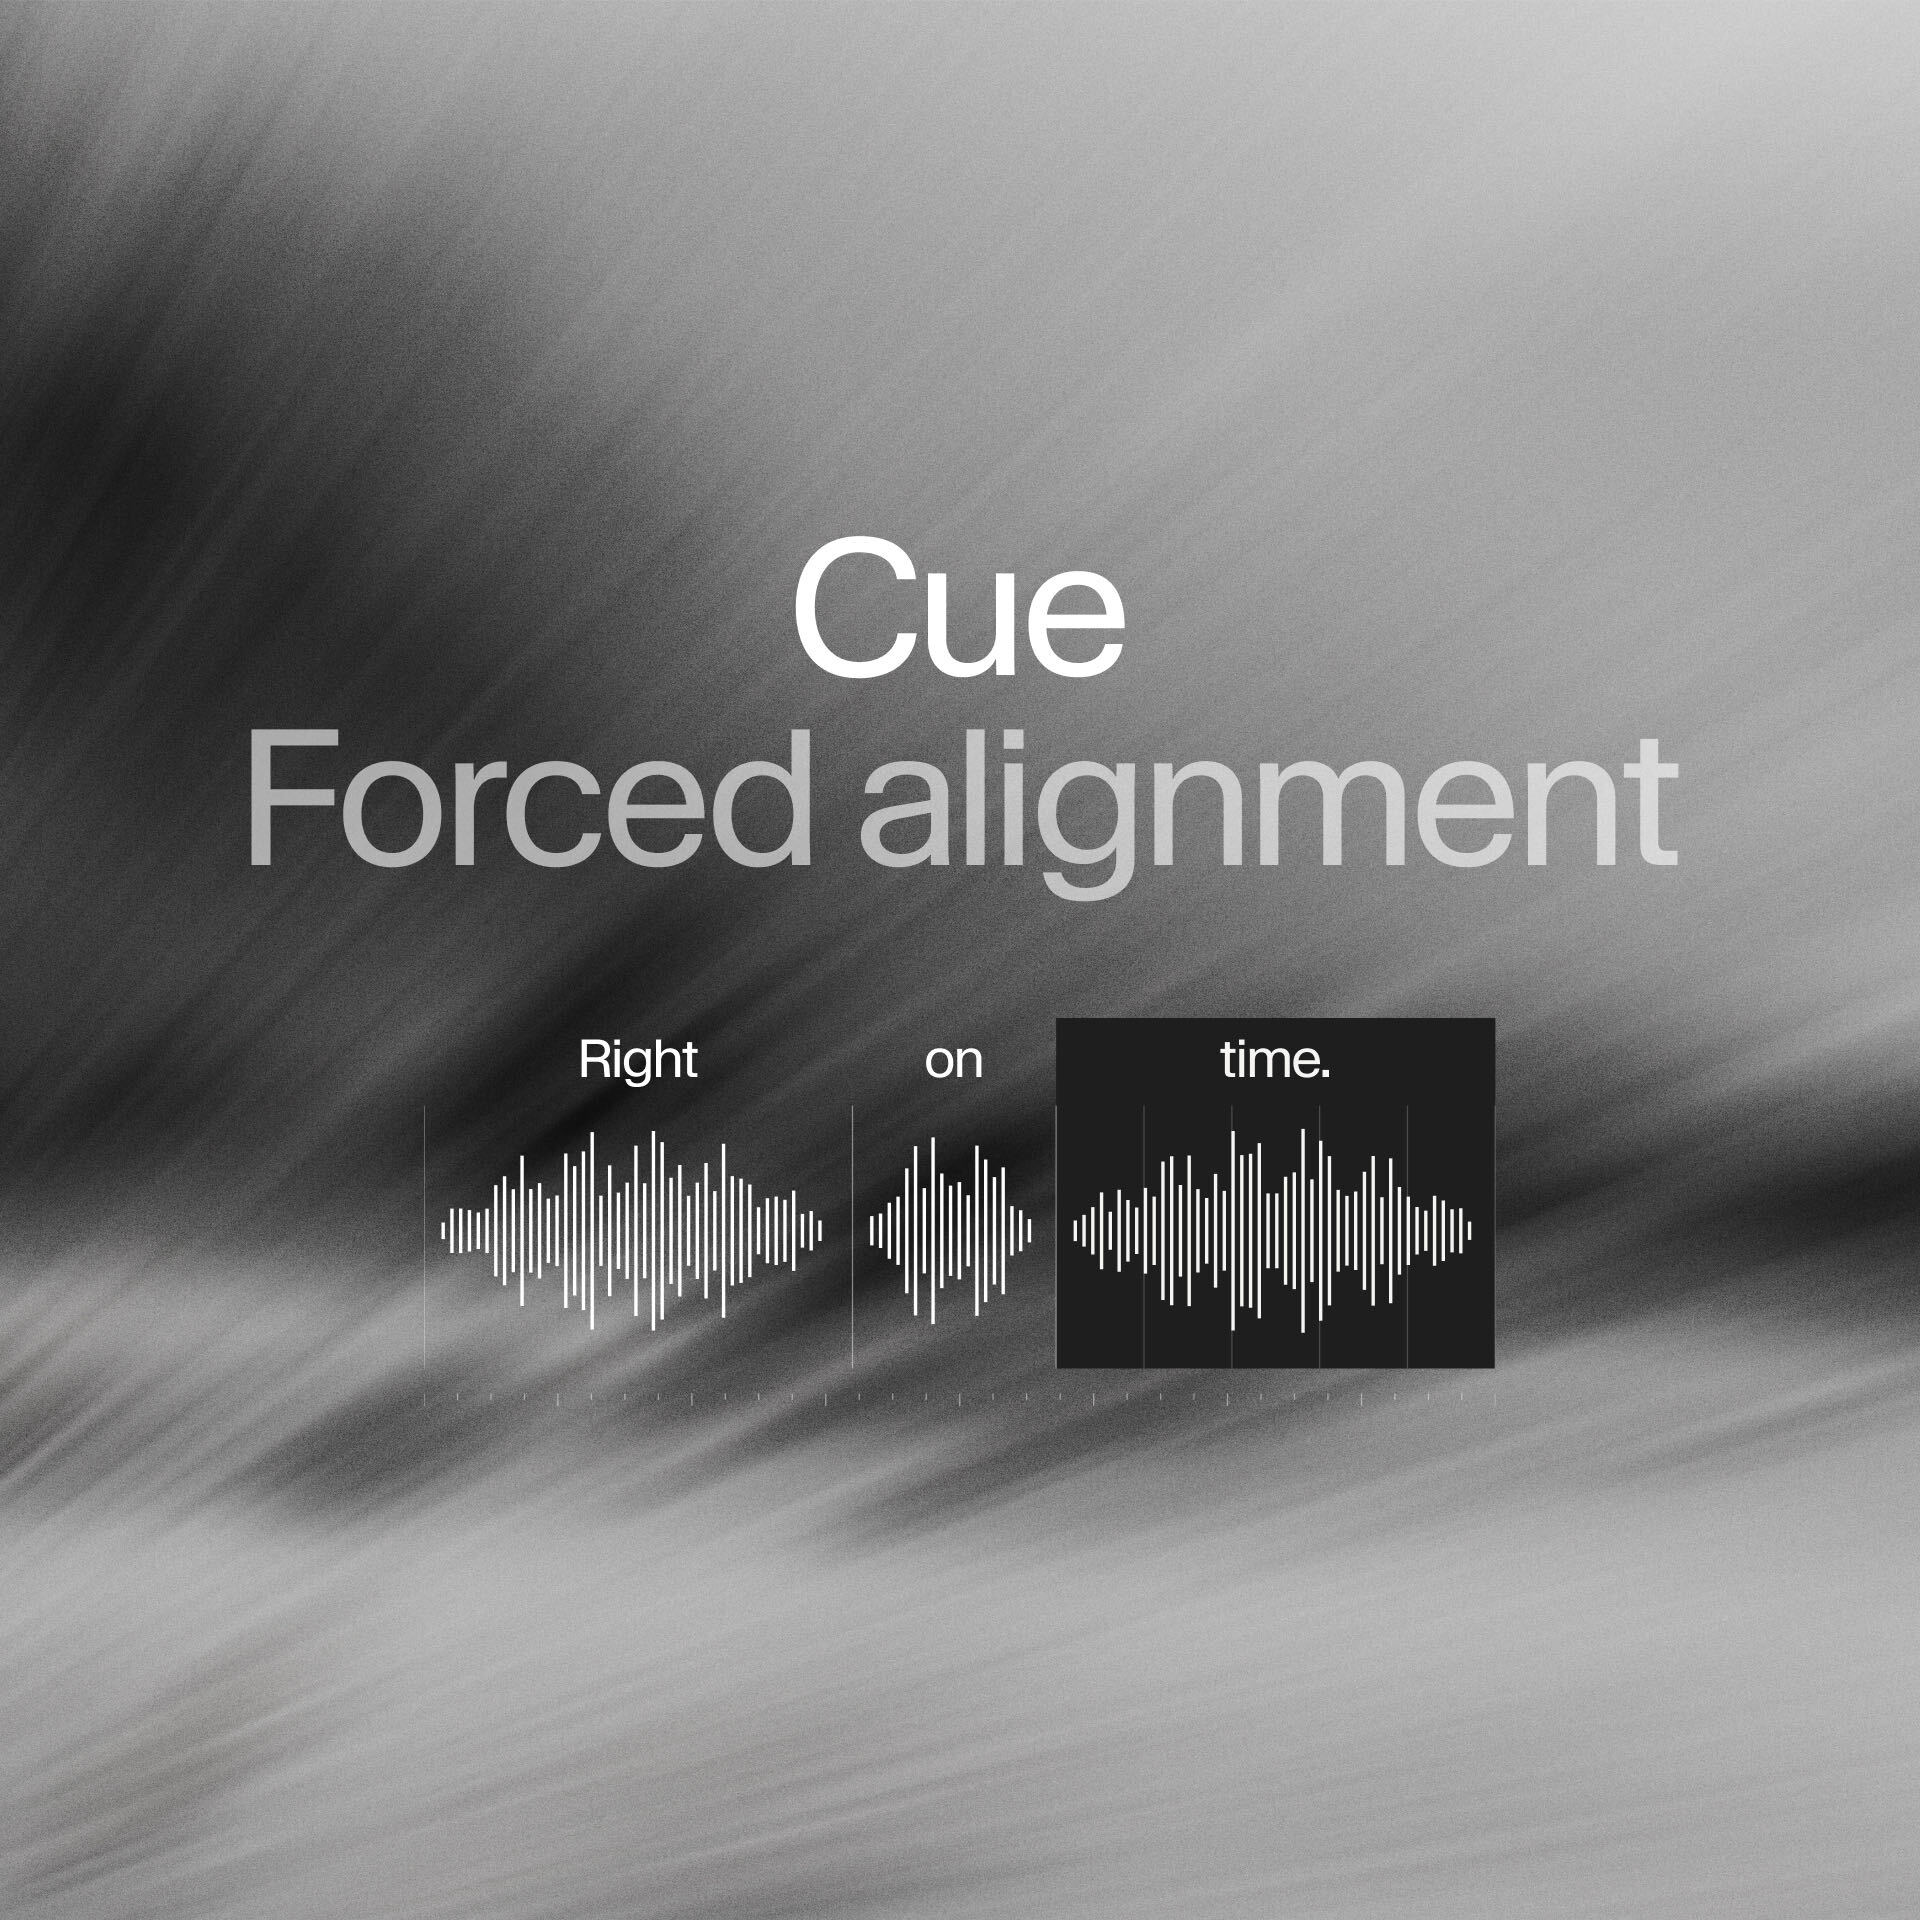
ElevenLabs 发布 Cue 字幕对齐到字符时间线
ElevenLabs 10月28日介绍 Cue 强制对齐模型,可把转写文字定位到字符级音频时间线,已用于 Scribe,并通过独立 API 提供。
强制对齐负责把已有文字与说话时刻对应起来,可用于字幕、配音和歌词时间轴。Cue 支持长录音单次处理,减少分段拼接带来的时间误差。
ElevenLabs 称,在其29种语言的实录音频测试中,Cue 优于所测其他对齐器。一小时音频约半秒的数字来自厂商生产 GPU 上的对齐计算,不是含上传、转写和下载的端到端耗时。
原始来源:ElevenLabs ↗
08 / 国外
Suno MCP 开放申请 在 AI 对话里继续做音乐
Suno 10月28日宣布 MCP Beta 并开放早期接入申请。连接支持 MCP 的助手后,可在对话里创作、延长或改编歌曲,使用现有 Suno 额度,作品保存回曲库。
官方页面列出 ChatGPT、Claude、Gemini、Claude Code 和 Cursor 等连接方式。连接使用 Suno 登录授权,无需另填 API key;部分助手仅在特定付费计划中提供连接器。
用户可沿用当前对话中的歌词、项目和视频计划,也能用已有音频继续创作。当前入口仍标为早期申请,不能将连接说明理解为每个账户都已获准使用。作品的商业使用权仍需结合所用套餐和对应许可另行核对,连接功能本身未宣布扩大许可。
原始来源:Suno ↗
09 / 国外
Perplexity 更新语音 一次对话调度多个任务
Perplexity 10月28日宣布新版语音模式,Pro 和 Max 用户可在网页或 Mac 应用中,通过一次语音会话调度多个 Computer 会话并管理 Projects。
官方列出的功能包括跨多个会话继续工作、启动新任务,以及创建和管理 Projects。对需要同时跟进多个工作的用户,语音成为任务调度入口。
Perplexity 表示这一模式使用 OpenAI 的 gpt-live-1。此次公告明确覆盖网页和 Mac 应用,没有在该公告中宣布手机端同步开放。
原始来源:Perplexity ↗
10 / 国外
NVIDIA 开放新语音模型 转写、翻译、区分说话人
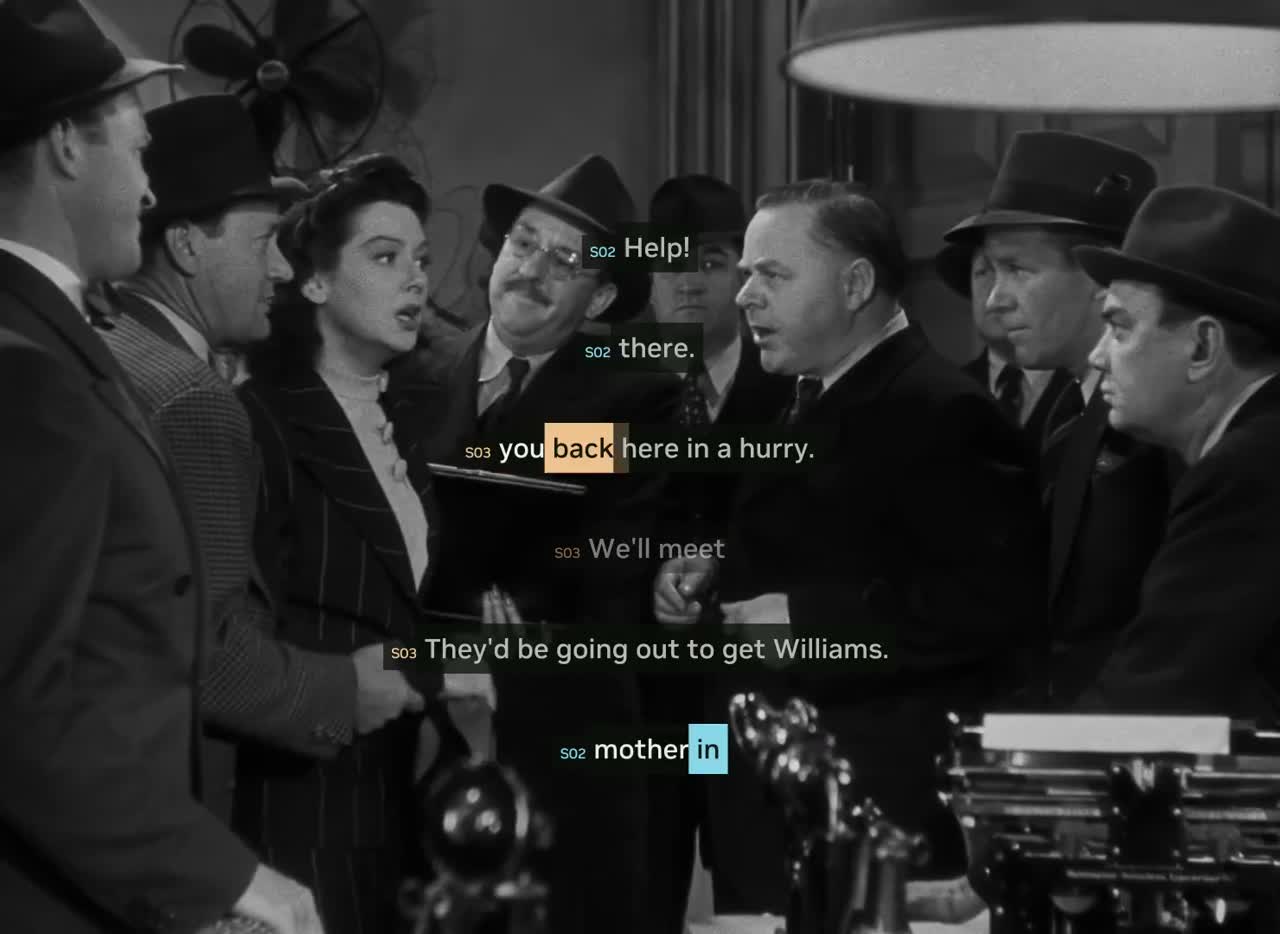
NVIDIA 10月28日开放 Nemotron 3.5 Transcribe 权重,支持40种语言转写、31种语言与英语互译、13种语言说话人标注,可处理最长一小时录音和最多8名说话人。
模型可按自然语言指令输出转写、翻译、说话人标签或录音问答;不同任务的语言范围不同,音频问答训练语言为英语。当前已有权重、演示和托管端点,也支持自托管服务。
它面向录制音频,不是实时流式识别。官方技术文章明确说明量化版本和 NeMo-Speech.cpp 本地部署路线将随后推出。公开权重与商业使用许可不是同一概念,本条不把权重开放表述为无条件商用授权。
原始来源:NVIDIA ↗
11 / 国外
VEED 配音接入 fal 多语言翻译与声音克隆
fal 于10月28日宣布 VEED Dubbing 上线,提供 Standard 与 Pro 接口。官方称 Pro 支持94种语言、14种地区口音,保留背景音并处理多个说话人。
公告介绍了克隆声音和口型同步的视频翻译功能,并提供目标口音、声音克隆强度控制。数字明确标注在 Pro 档描述中,不应套用到所有档位。
对多语言视频制作,可从公告提供的对应模型入口查看分档能力。本期只展示供应商发布的演示,没有对各语言的口音、声音相似度与口型精度进行独立实测。
原始来源:fal / VEED ↗
12 / 国外
AMD 宣布投资 Meta Helios 已安装并进入测试
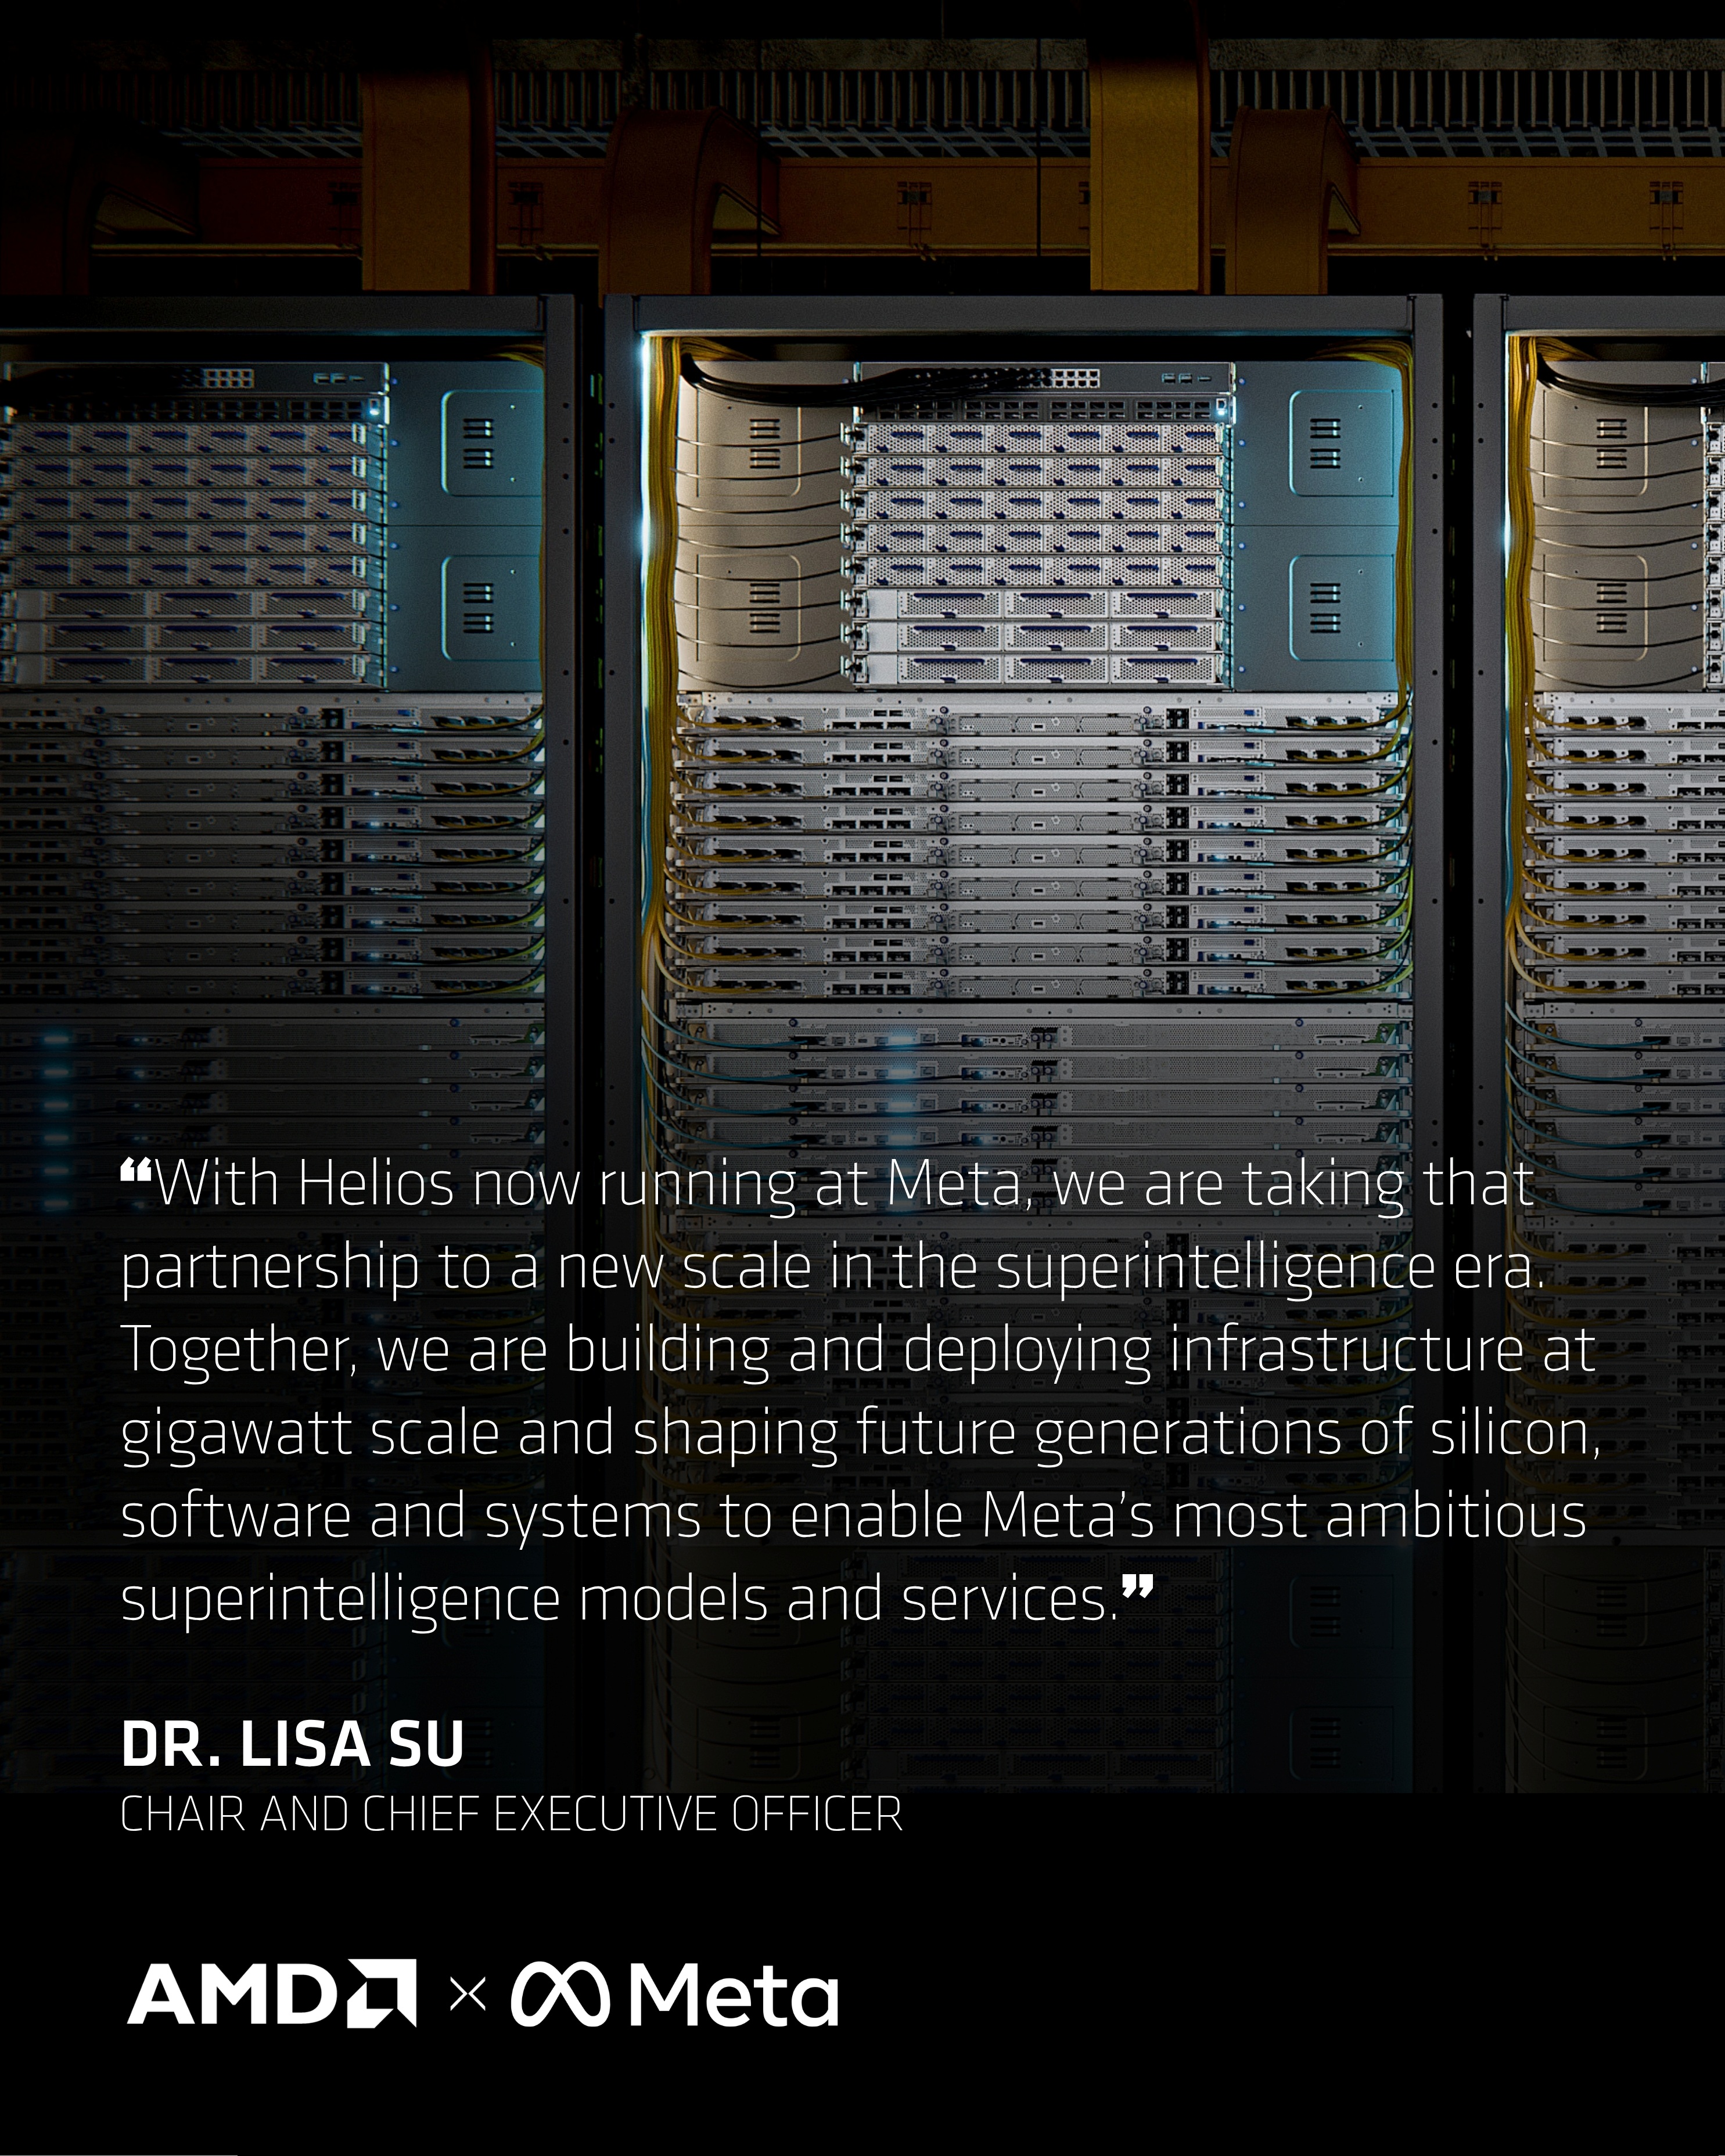
AMD 在10月27日公告中表示,将向 Meta 的股权发行投资10亿美元。首批 Helios 机架级系统已安装并由 Meta 测试,更大规模部署将在后续推进。
AMD 表示,EPYC 处理器支撑 Muse 个人 AI 代理的专用计算环境,Instinct GPU 已用于 Meta 的训练、排序和推荐等生产任务。双方还围绕 CPU、GPU、网络和软件协同产品路线。
本条投资方是 AMD,金额为10亿美元,公告使用的是将投资的表述。Helios 的已安装测试状态,与未来扩大部署、定制产品的计划分别陈述,未把投资计划写成已完成交割。
原始来源:AMD ↗
国内
13 / 国内
图生视频新版评测 Seedance 与 H3 各有强项
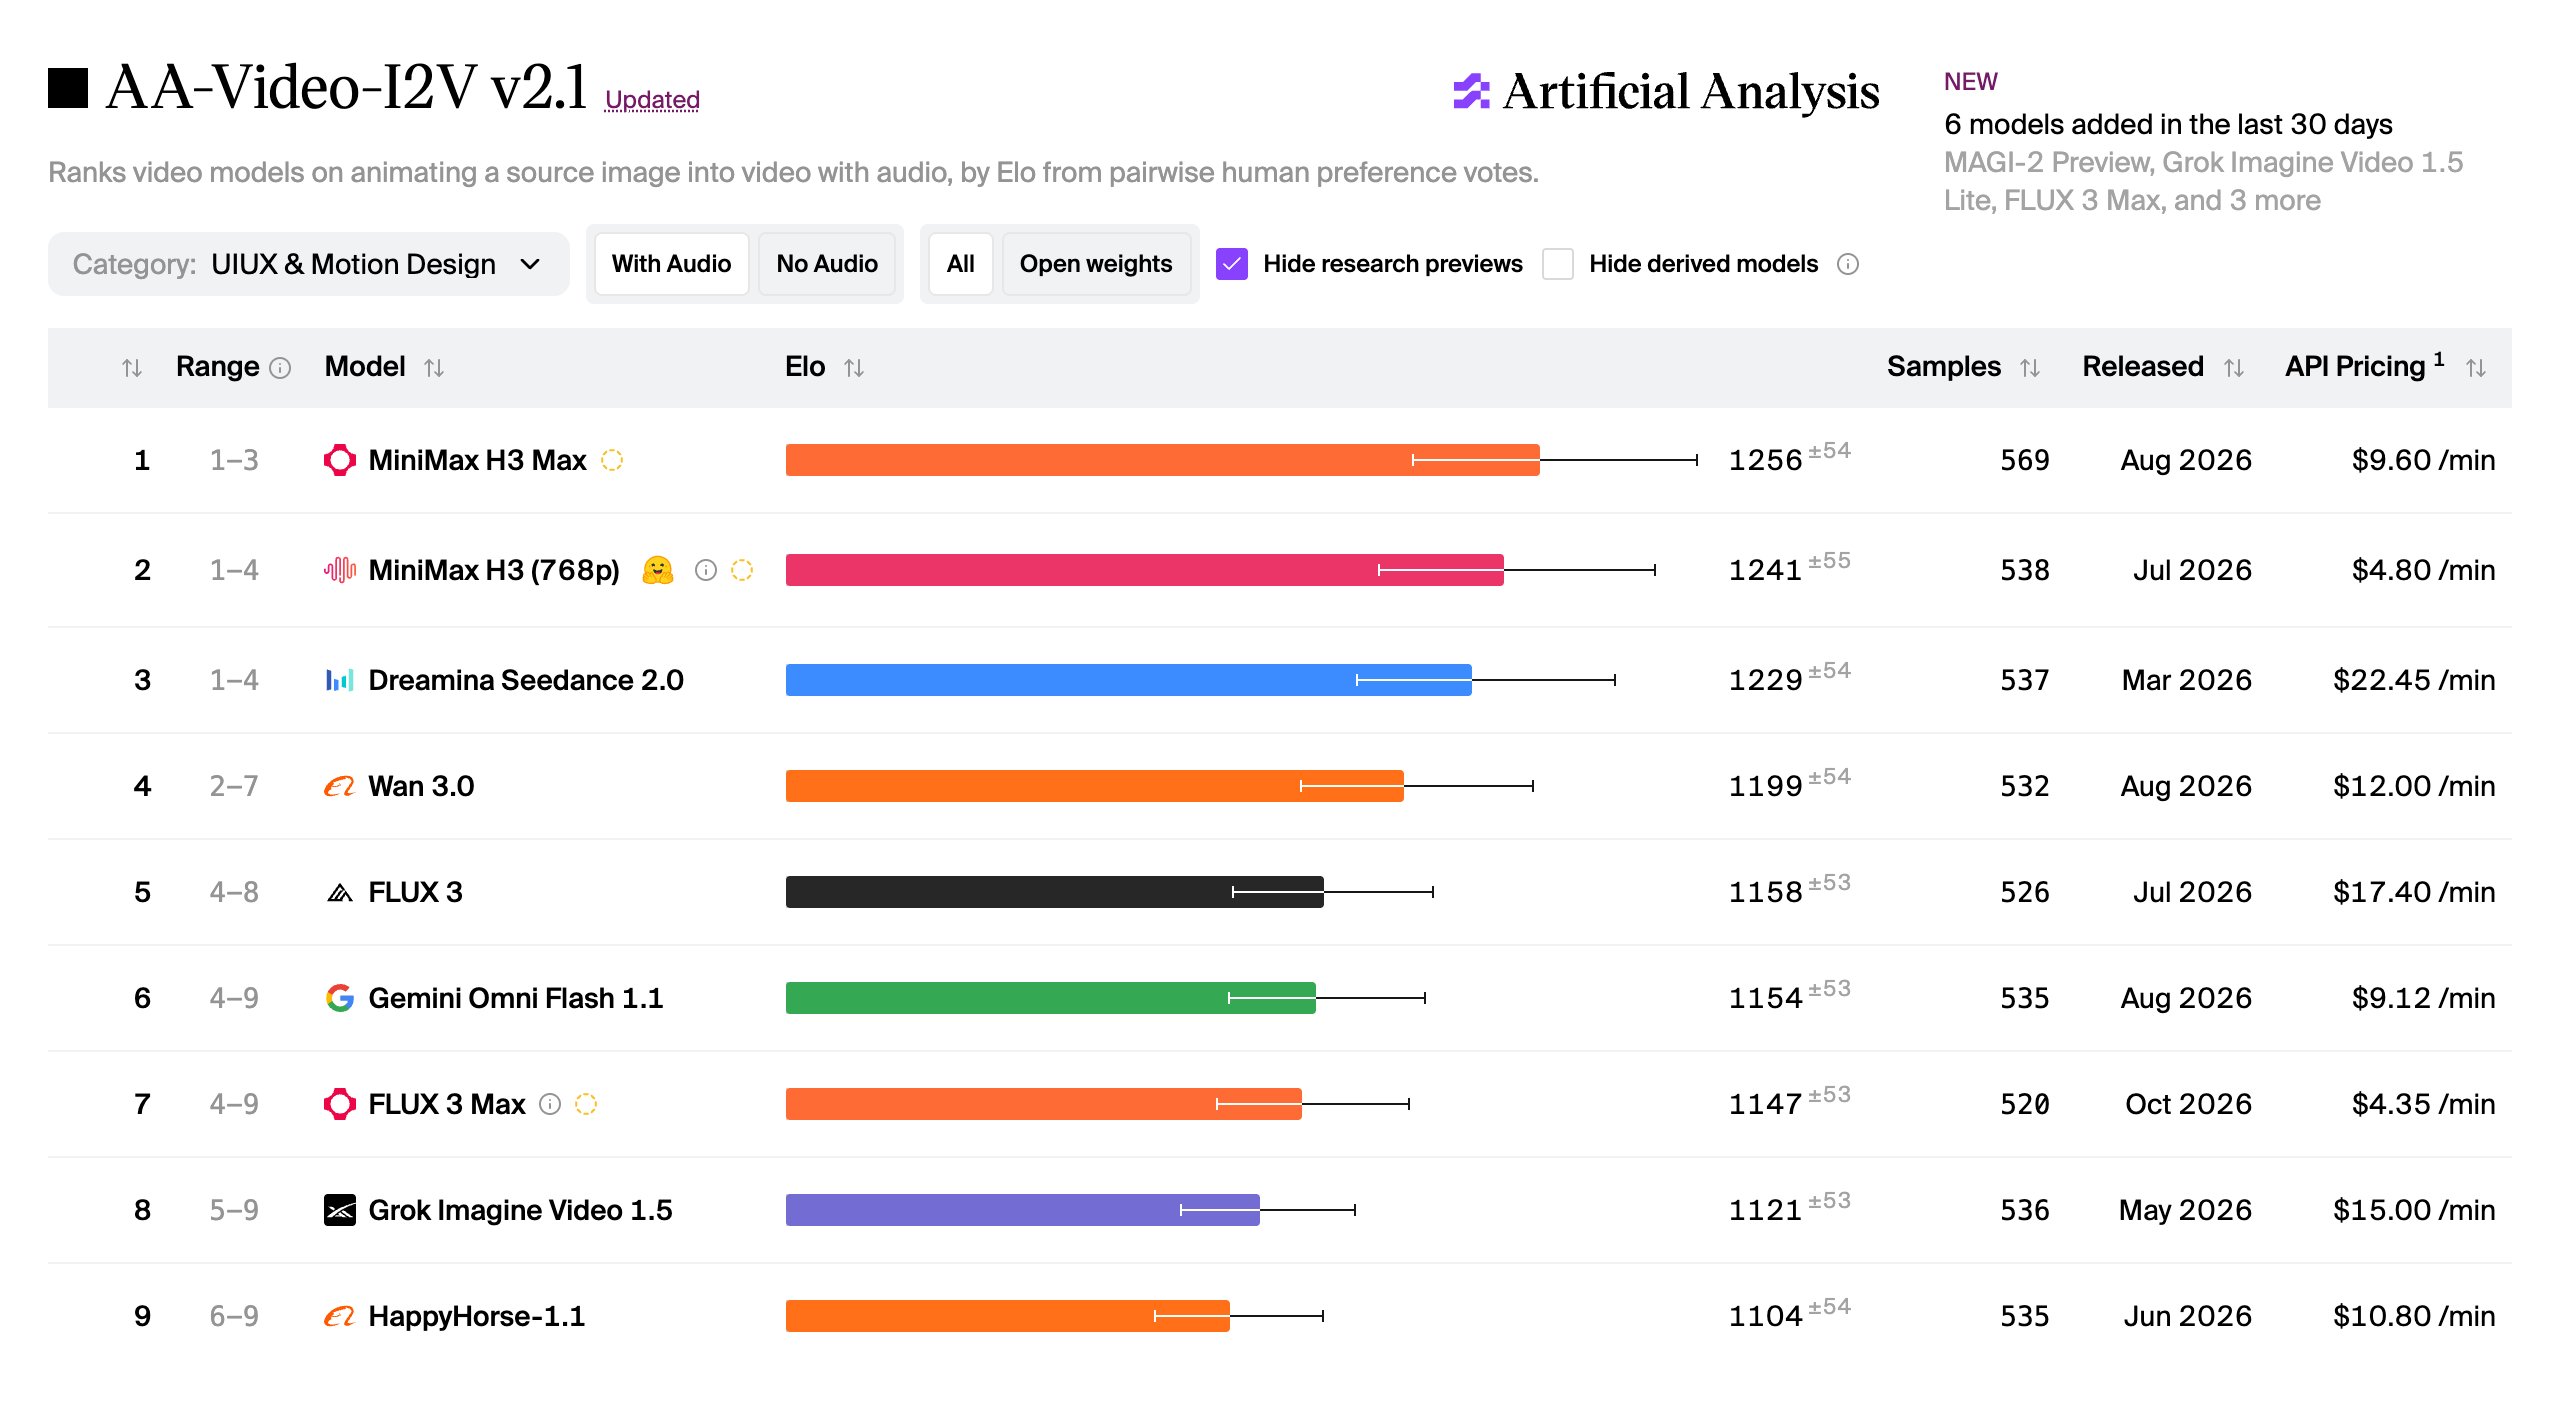
Artificial Analysis 10月28日发布 AA-Video-I2V v2.1 与无声版评测。Seedance 2.5 居有声榜首,与 Seedance 2.0 及 MiniMax H3 家族统计上接近;fal 后训练的 H3 Max 居无声榜首。
评测使用1080p起始图和配套文字提示,模型输出最高按1080p测试,覆盖10类用途、10类能力和多种视觉风格。有声评测基于1000条提示、超过5.8万人类偏好投票;无声评测基于500条提示、超过4.4万票,评审者来自美国和英国。
Seedance 2.5 在多项分类表现靠前,但该榜列出的每分钟成本也是前十最高。MiniMax H3 以768p参与;H3 Max 是 fal 在其基础上的后训练版本,擅长时空一致性和界面动效。选择模型时应同时看画面类型、声音要求、分辨率和成本,而非只看总名次。
14 / 国内
可灵 4.0 新增入口 接入 PixVerse 与 Pika
PixVerse 与 Pika 于10月28日宣布接入可灵4.0,两家公告均提到最长30秒视频生成。本次新增是平台使用入口,模型并非当天首次发布。
PixVerse 的公告强调单次生成最长30秒、跨多镜头保持人物一致,以及高速动作和复杂运镜。Pika 的公告则强调全能参考、多关键帧和最长30秒生成。
这些能力来自平台公告及演示,不能据此推断所有输入都能达到样例效果。两条帖子没有列明适用套餐和具体额度消耗,使用前需在各自入口核对。
原始来源:PixVerse / Pika ↗
15 / 国内
MiniCPM-OCR 适配苹果芯片 Mac 本地识别多一个选择
OpenBMB 10月28日宣布,MiniCPM-OCR 1.0 与 MiniCPM-OCR Jev 已支持 Apple Silicon,并披露 M5 Max 上的运行数据。此次新增是苹果芯片适配。
公告称适配来自与 Neywa Labs 团队的合作。OCR 1.0 为13亿参数,Jev 为20亿参数;Jev 用于给 OCR 结果评分。
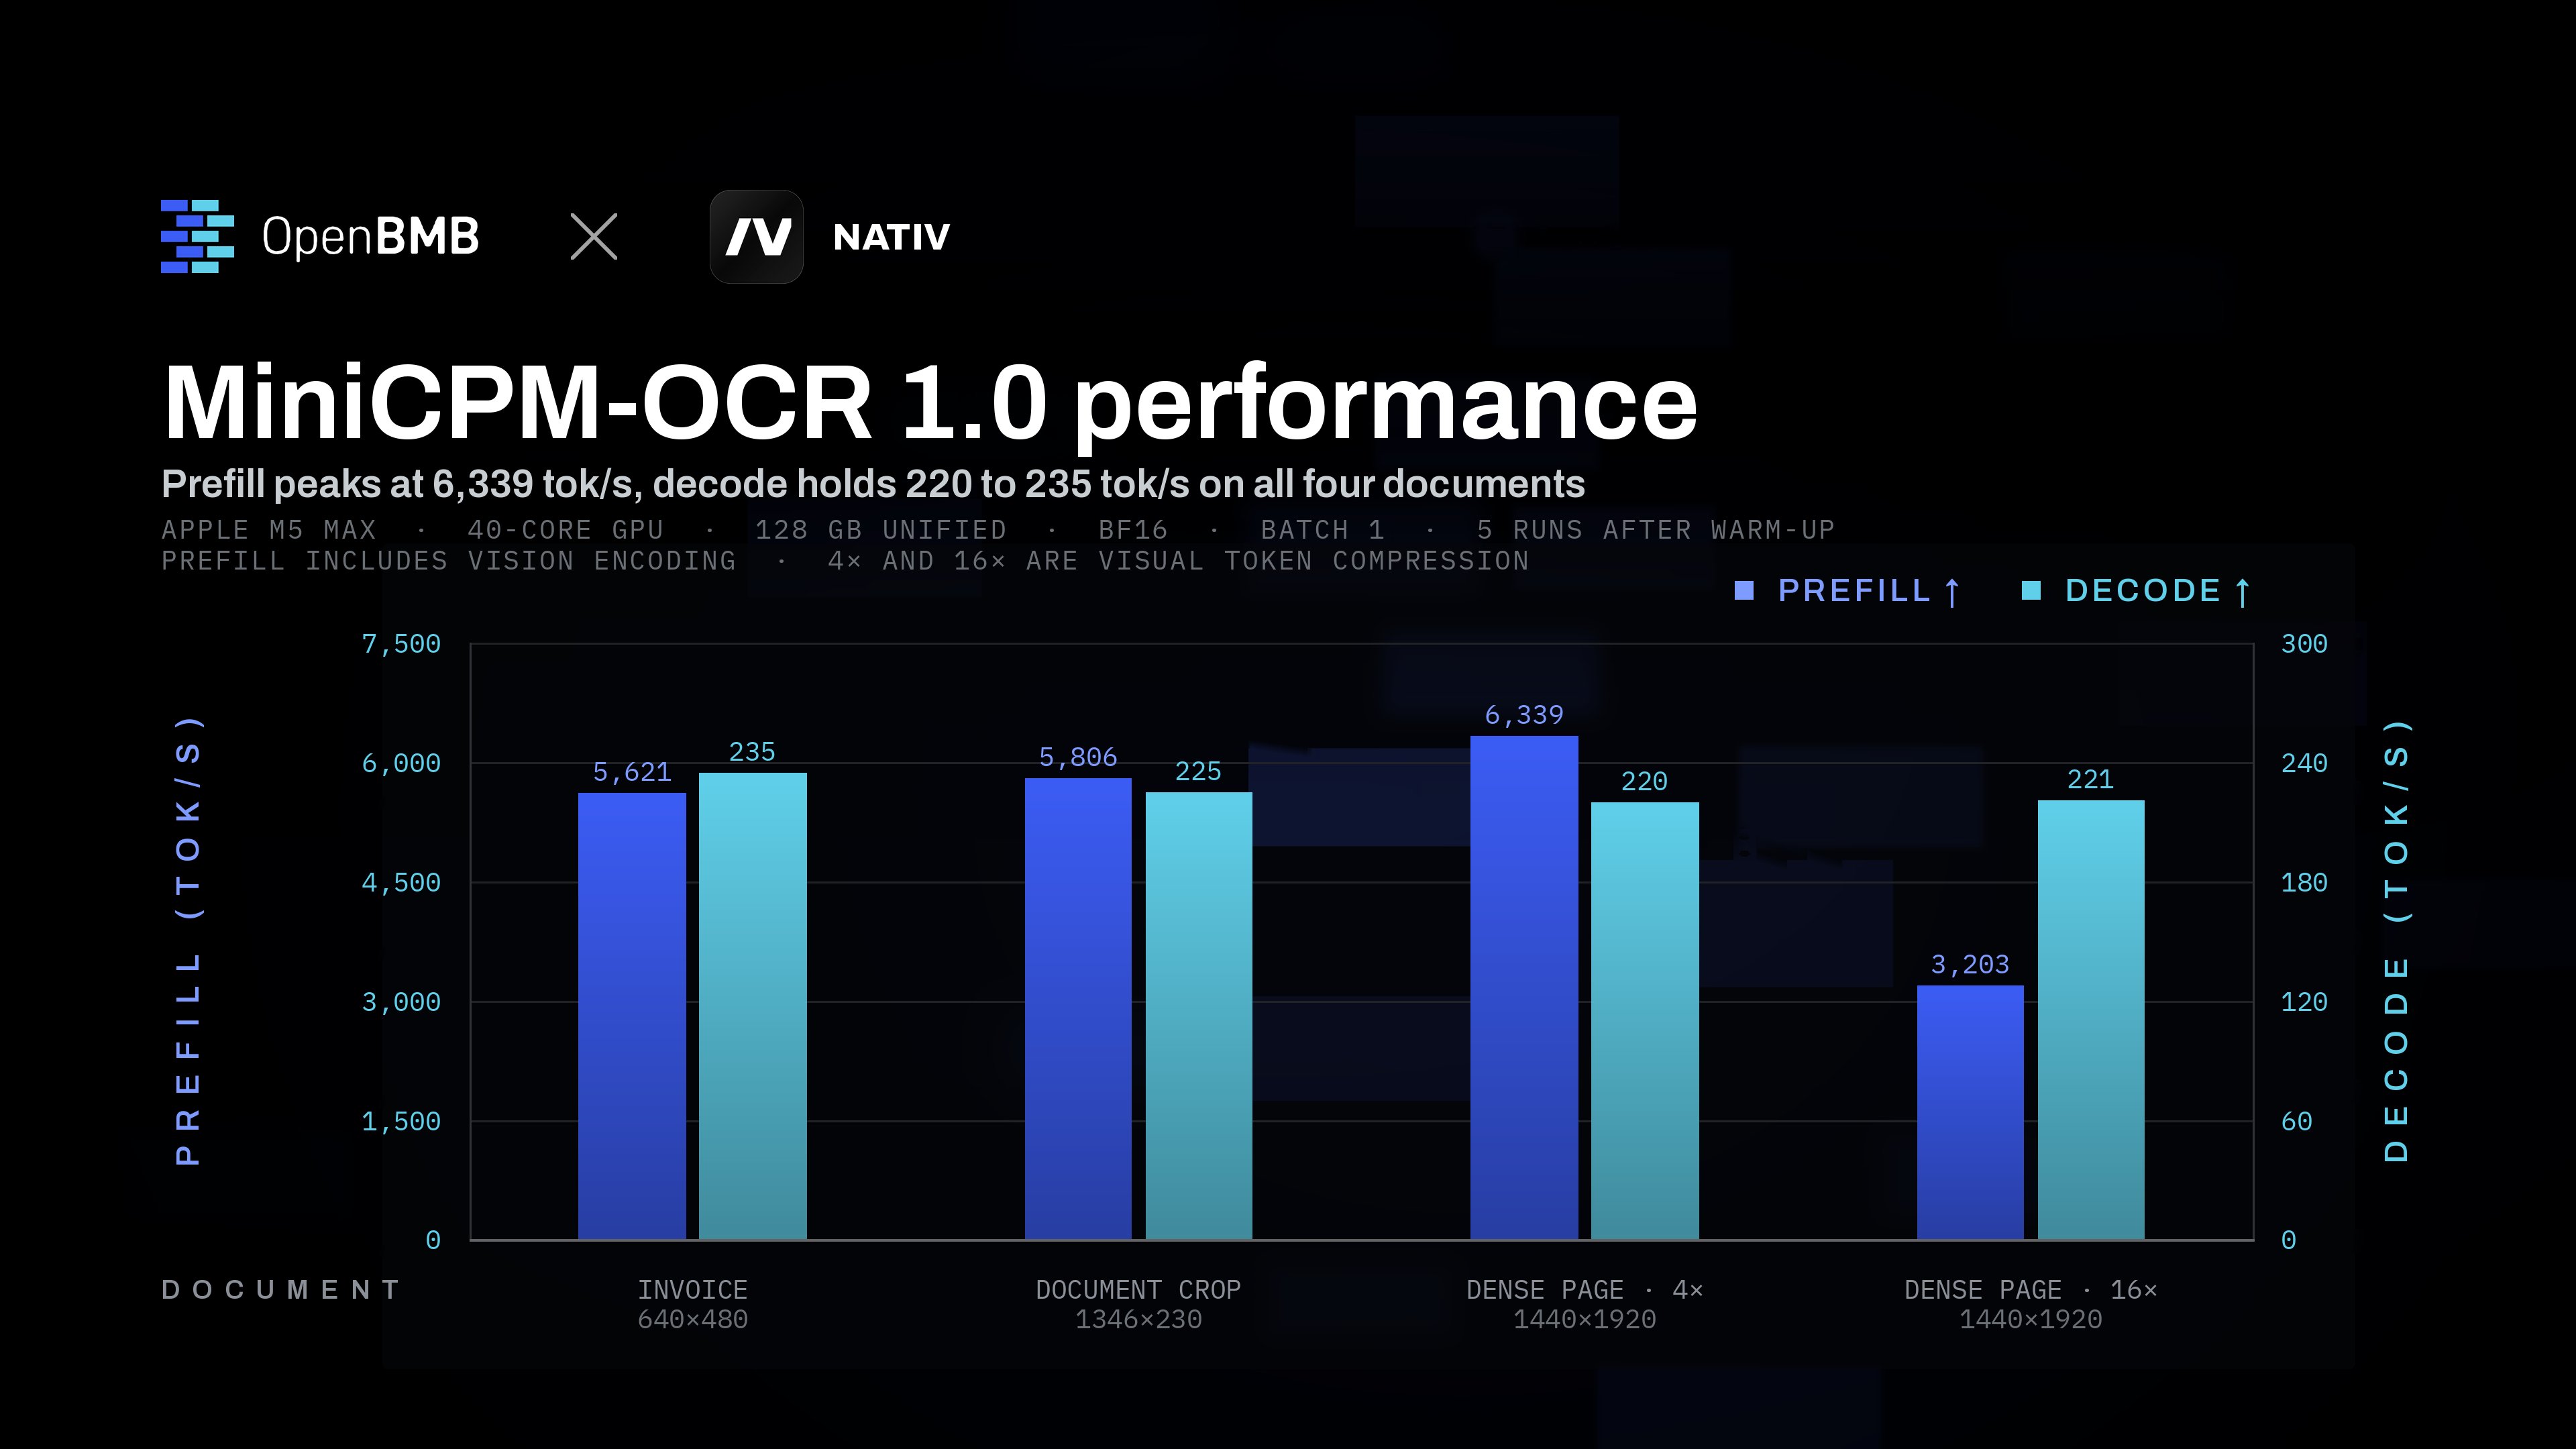
官方在 M5 Max 上报告 OCR 1.0 每秒220至235 token 的解码速度,Jev 评分的延迟中位数为62.9毫秒。这是指定设备上的厂商数据,不是对所有 Mac 的速度承诺。本条不重复前一期的 OCR 首发报道。
原始来源:OpenBMB ↗
16 / 国内
蚂蚁开源百灵新版本 面向复杂任务继续优化
蚂蚁 inclusionAI 于10月27日宣布开源 Ling-3.1-flash-1019,并同步发布基础模型。模型卡列出5600亿总参数、250亿激活参数、百万 token 上下文和 MIT 许可。
官方称经过进一步后训练,新版本在推理与多步骤任务方面改进;模型卡列出的 Artificial Analysis Intelligence Index v4.3.2 得分从41升至44,流程自动化等评测也有提升。这些数值在本条中归于官方披露。
基础模型面向继续训练与领域适配。官方部署示例使用多张数据中心 GPU,开放权重和 MIT 许可并不表示普通电脑即可运行。该消息与灵光2.0应用更新分别属于模型层和产品层的进展。
原始来源:蚂蚁 inclusionAI ↗
内容依据所列原始来源整理,官方演示和厂商测试均按出处标注;视频使用数字形象与AI配音。
把关注,变成持续的探索。
回看其他期次,或在你习惯的平台继续关注。