国内
01 / 今日头条
DeepSeek开源推理框架与编解码组件
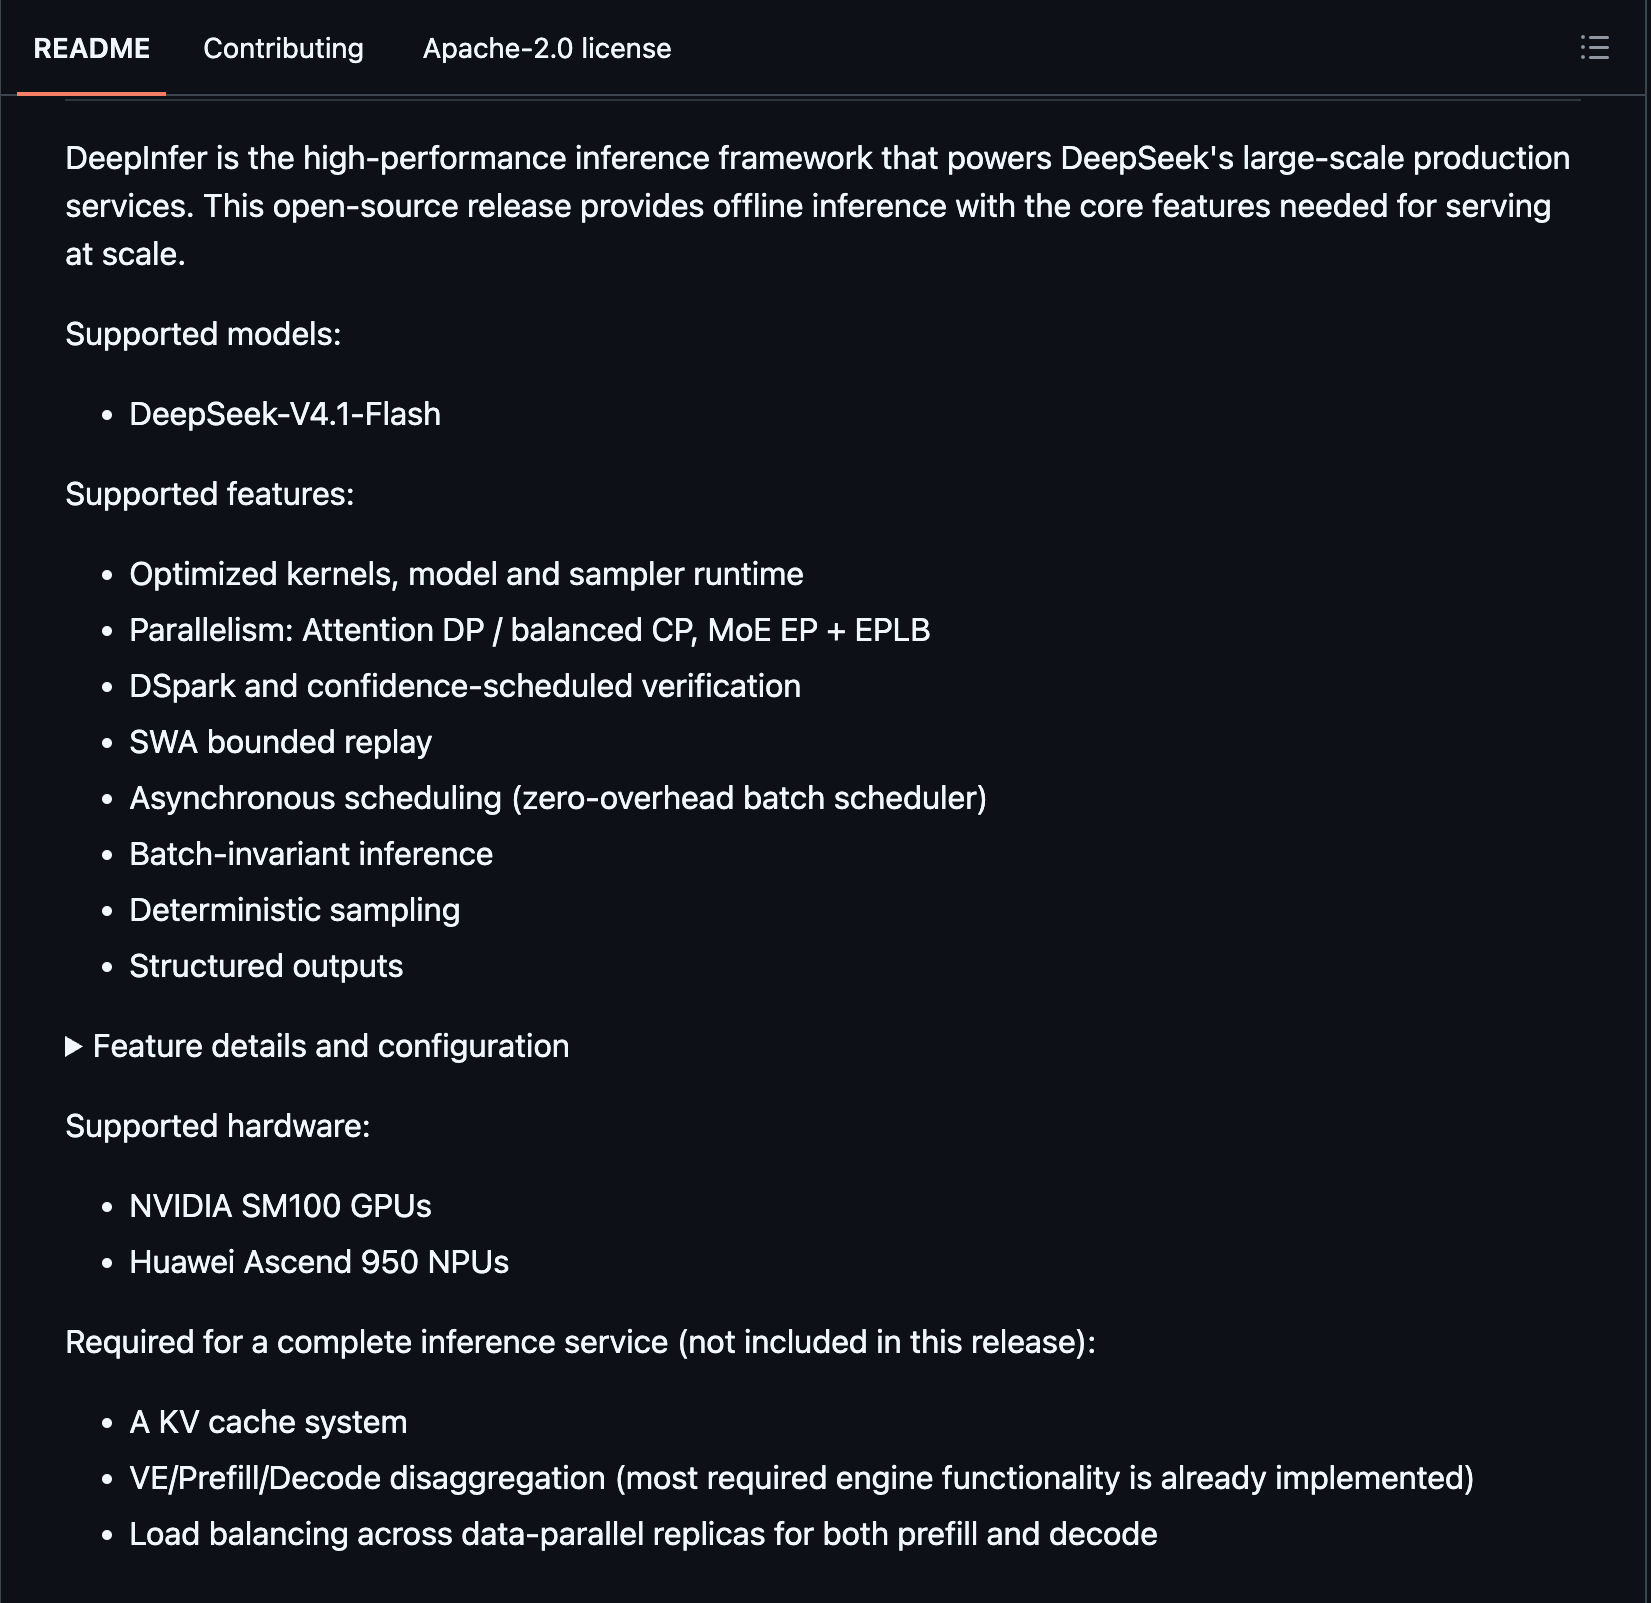
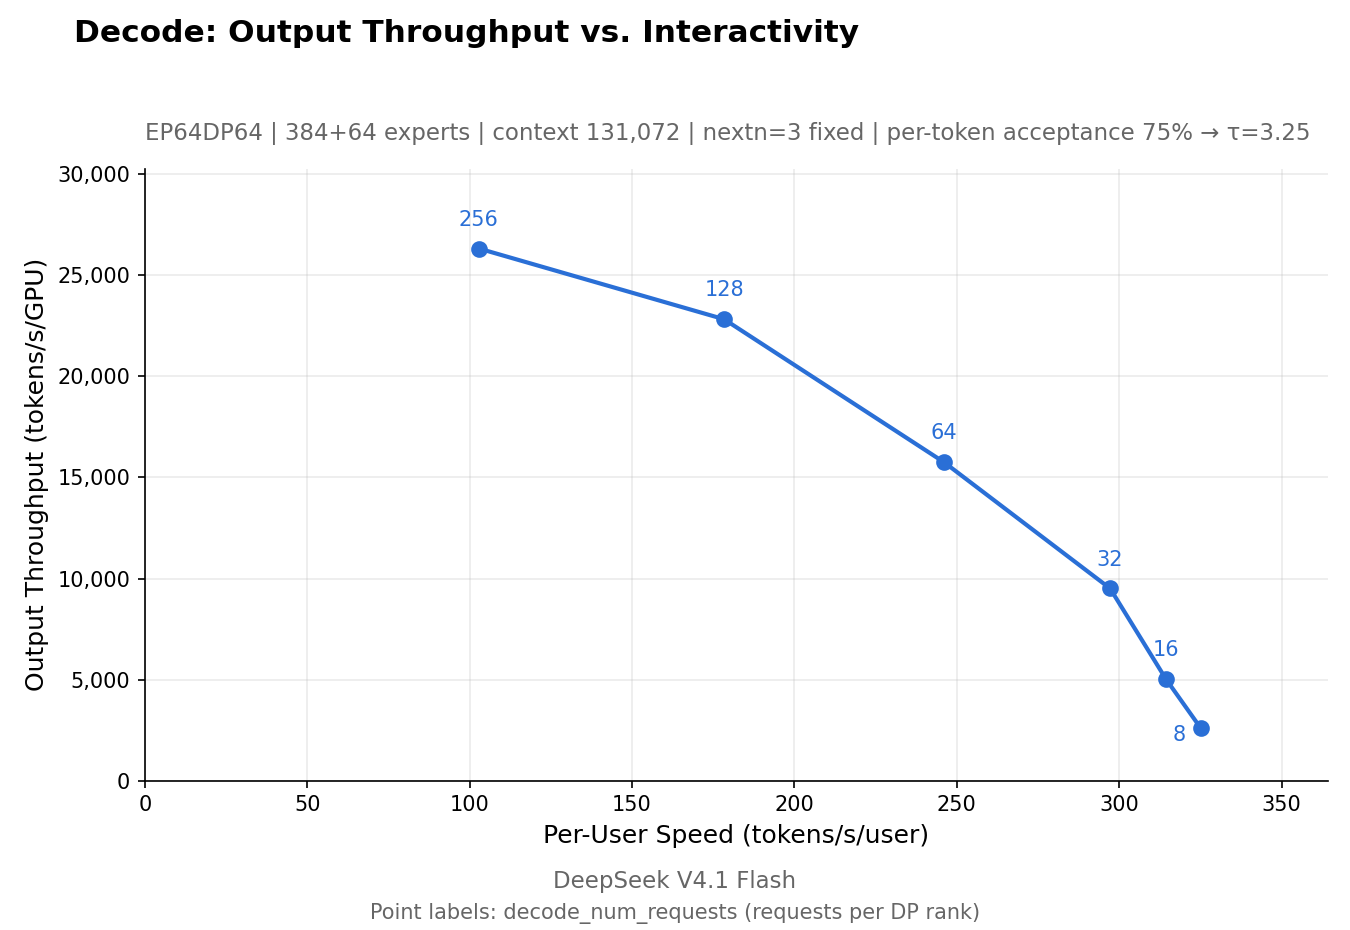
DeepSeek于10月20日开源DeepInfer及deepseek-recipe,分别提供V4.1 Flash离线推理实现和多种API格式的编解码组件。
DeepInfer支持NVIDIA SM100 GPU和华为昇腾950 NPU,开放优化内核、异步调度、结构化输出等能力,采用Apache 2.0许可。它为部署团队提供可研究和复用的推理实现。
deepseek-recipe采用MIT许可,可转换Messages、Chat Completions和Responses格式,处理提示词编码及模型输出解析。调用者仍须提供模型推理、工具执行与HTTP传输;完整推理服务所需的KV缓存、服务解耦和跨副本负载均衡不包含在本次DeepInfer发布中。
原始来源:DeepSeek ↗
国外
02 / 智能体与办公
Perplexity Computer可在Mac全本地运行
Perplexity为Pro、Max和Enterprise用户开放Mac全本地Computer,推荐36GB以上统一内存,本地任务不消耗Computer积分。
在支持的Apple芯片Mac上,用户可通过Perplexity应用下载本地模型,让模型、规划和任务执行留在设备端。获得授权后,Computer能够使用本地文件及Notes、Mail等应用。
本地任务不扣Computer积分。用户可为实时信息、浏览器和连接应用授权云端升级,也可选择结合云端推理与本地处理的Hybrid Compute。36GB以上是官方推荐配置,具体设备仍须满足应用支持条件。
原始来源:Perplexity ↗
03 / 智能体与办公
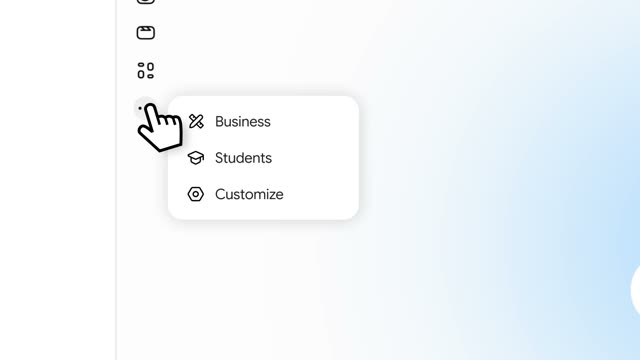
Gemini为小企业新增品牌与财务工具
Google宣布Gemini小企业工作入口,可保存品牌风格、连接业务应用,并把经营数据转换为财务图表;未来几天逐步全球开放。
新入口集中品牌建设、财务分析和客户洞察,支持Google Business Profile、Google Ads、Workspace及Adobe、Canva、Shopify等第三方应用连接。
用户可上传品牌资料,配合Nano Banana 2.1生成保持一致风格的营销视觉;也可将收据、采购记录和表格转换为财务图形与交互模型。公告日期为10月20日,开放按未来几天逐步推进,账号出现入口的时间可能不同。
原始来源:Google ↗
04 / 常用产品功能
ChatGPT逐步开放锁定聊天
ChatGPT逐步开放锁定聊天,可用账户PIN或支持设备的生物识别解锁。重置PIN会永久删除锁定聊天及仅受旧PIN保护的内容。
功能覆盖Free、Go、Plus、Pro、Business、Enterprise和Edu。锁定聊天从普通历史、置顶和普通搜索中隐藏,可在Projects下的Locked chats进入;桌面端要求新的ChatGPT应用,Codex及本地Work对话不在支持范围。
加锁不改变端到端加密状态、保留期限或模型改进设置。新增锁定聊天记忆不流入普通聊天,之前已形成的普通记忆也不会因加锁自动清除。重置PIN具有永久删除后果,不能与正常修改PIN混为一谈。
原始来源:OpenAI ↗
05 / 语音与音频
Mistral推出Voxtral 3语音模型与智能体SDK
Mistral发布Voxtral 3语音系列及实时智能体SDK,支持多语言转录、合成和工具调用,现可通过API及Studio使用。
语音转录支持50多种语言,合成覆盖35多种语言和50多种方言。SDK将收听、推理、工具调用和语音输出连接为流式流程,面向客服和助手等应用。
官方定价中,Voxtral Mini Transcribe 3批量转录为0.0035美元/分钟,Speech 3为13美元/百万字符;实时转录等其他型号分别计价。企业可联系团队了解本地或私有云部署,不将可私有部署等同于全部权重已无条件开放。
原始来源:Mistral AI ↗
06 / 语音与音频
ElevenLabs推出Mini与Max实时语音模型
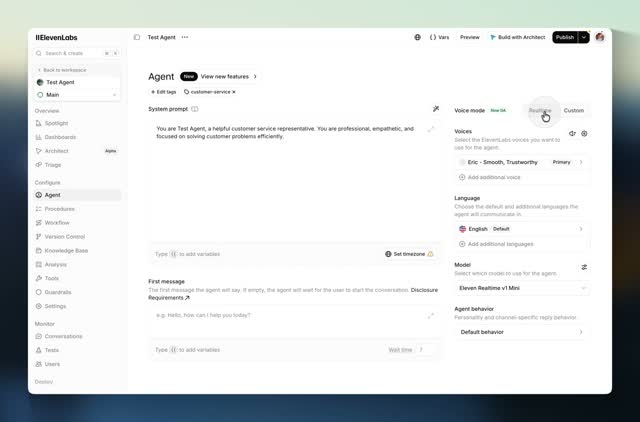
ElevenLabs发布Realtime v1 Mini和Max,支持90多种语言及现有声音库,分别面向自然对话与复杂工具任务。
两档模型均为Speech to Speech端到端语音模型,可在ElevenAgents选择。官方把Mini定位于低成本自然对话,把Max定位于客户支持、线索筛选及多步工作流。
Realtime API使用WebSocket并遵循OpenAI Realtime接口规范,WebRTC集成需先迁移传输方式。API与ElevenAgents平台分别提供,渠道、知识库和平台监控等功能应按所用产品配置。
原始来源:ElevenLabs ↗
07 / 智能体与办公
Notion个人Agent可连接ChatGPT订阅
Notion个人Agent可连接ChatGPT Plus、Pro和Go订阅;Business及Enterprise增加Standard与Select两类月积分,现有客户11月2日切换。
10月19日公告介绍了长任务执行、上下文压缩和模型路由升级。已有ChatGPT订阅的连接先用于个人Notion Agent,不包括Custom Agents;Enterprise自带模型密钥仍为私测。
Business和Enterprise席位每月含1500 Standard及500 Select积分,分别用于自动选模型和指定模型、Custom Agents等工作。新客户自公告日启用,现有客户11月2日切换;统一管理与用量控制入口AI Command Center尚属即将推出。
原始来源:Notion ↗
08 / 智能体与办公
ChatGPT团队任务支持共享周期工作
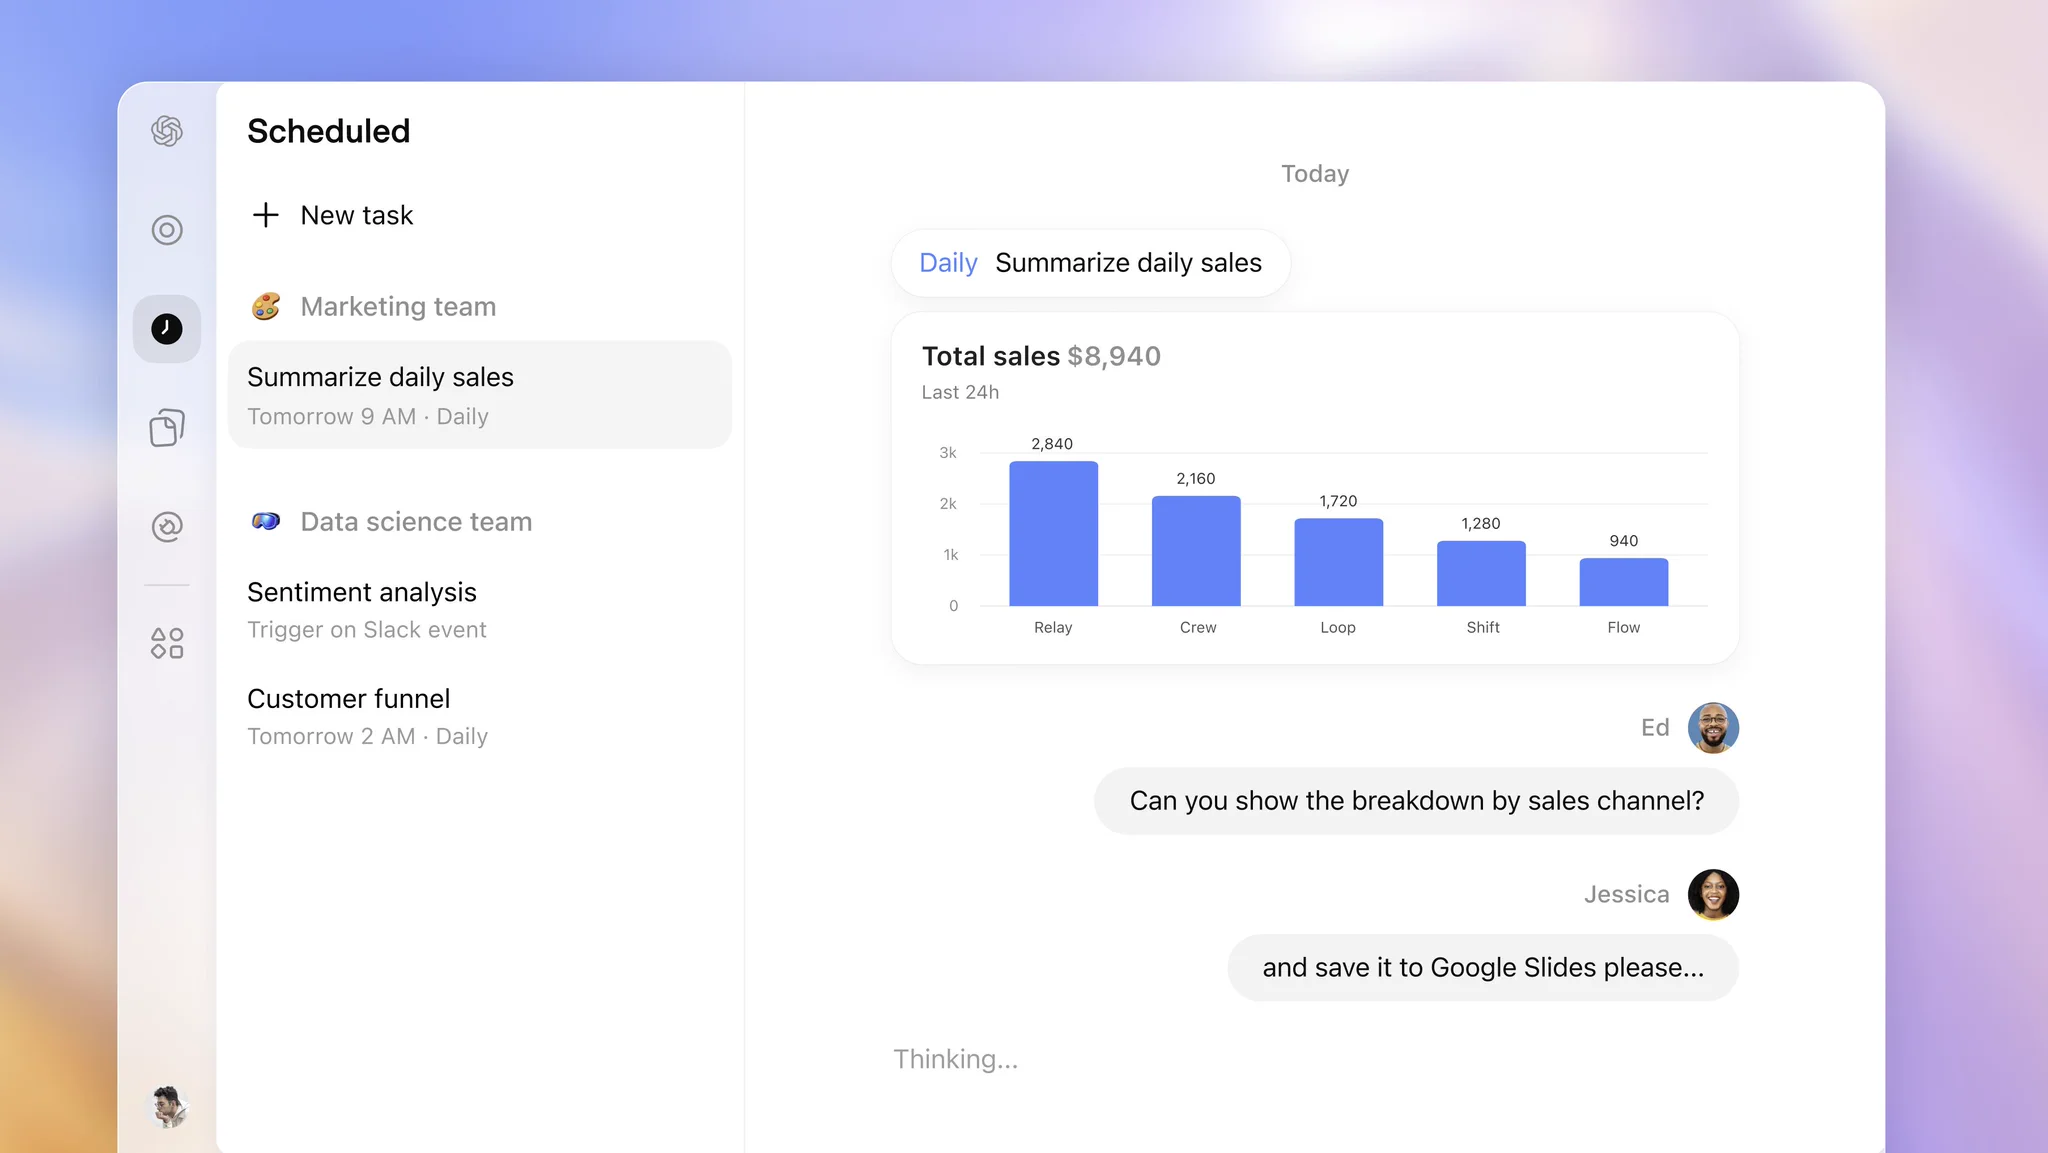
OpenAI介绍ChatGPT团队任务,可自动执行周期工程汇总,成员共同审阅并调整后续内容;操作说明面向符合条件的Enterprise工作区。
官方10月20日原帖以每周汇总交付和阻塞为例,展示周期工作由团队共同维护的方式。成员可审阅结果并改变下一次更新覆盖的内容。
原帖下官方补充说明:在符合条件的Enterprise工作区,先在Settings的Teams中建立团队、邀请成员、选择连接,再从Scheduled创建任务并选择团队、描述工作和时间。没有据此扩写为所有个人订阅都可使用。
原始来源:OpenAI Developers ↗
09 / 图像与创作
Krea 3 Ultra登上Arena图像编辑榜
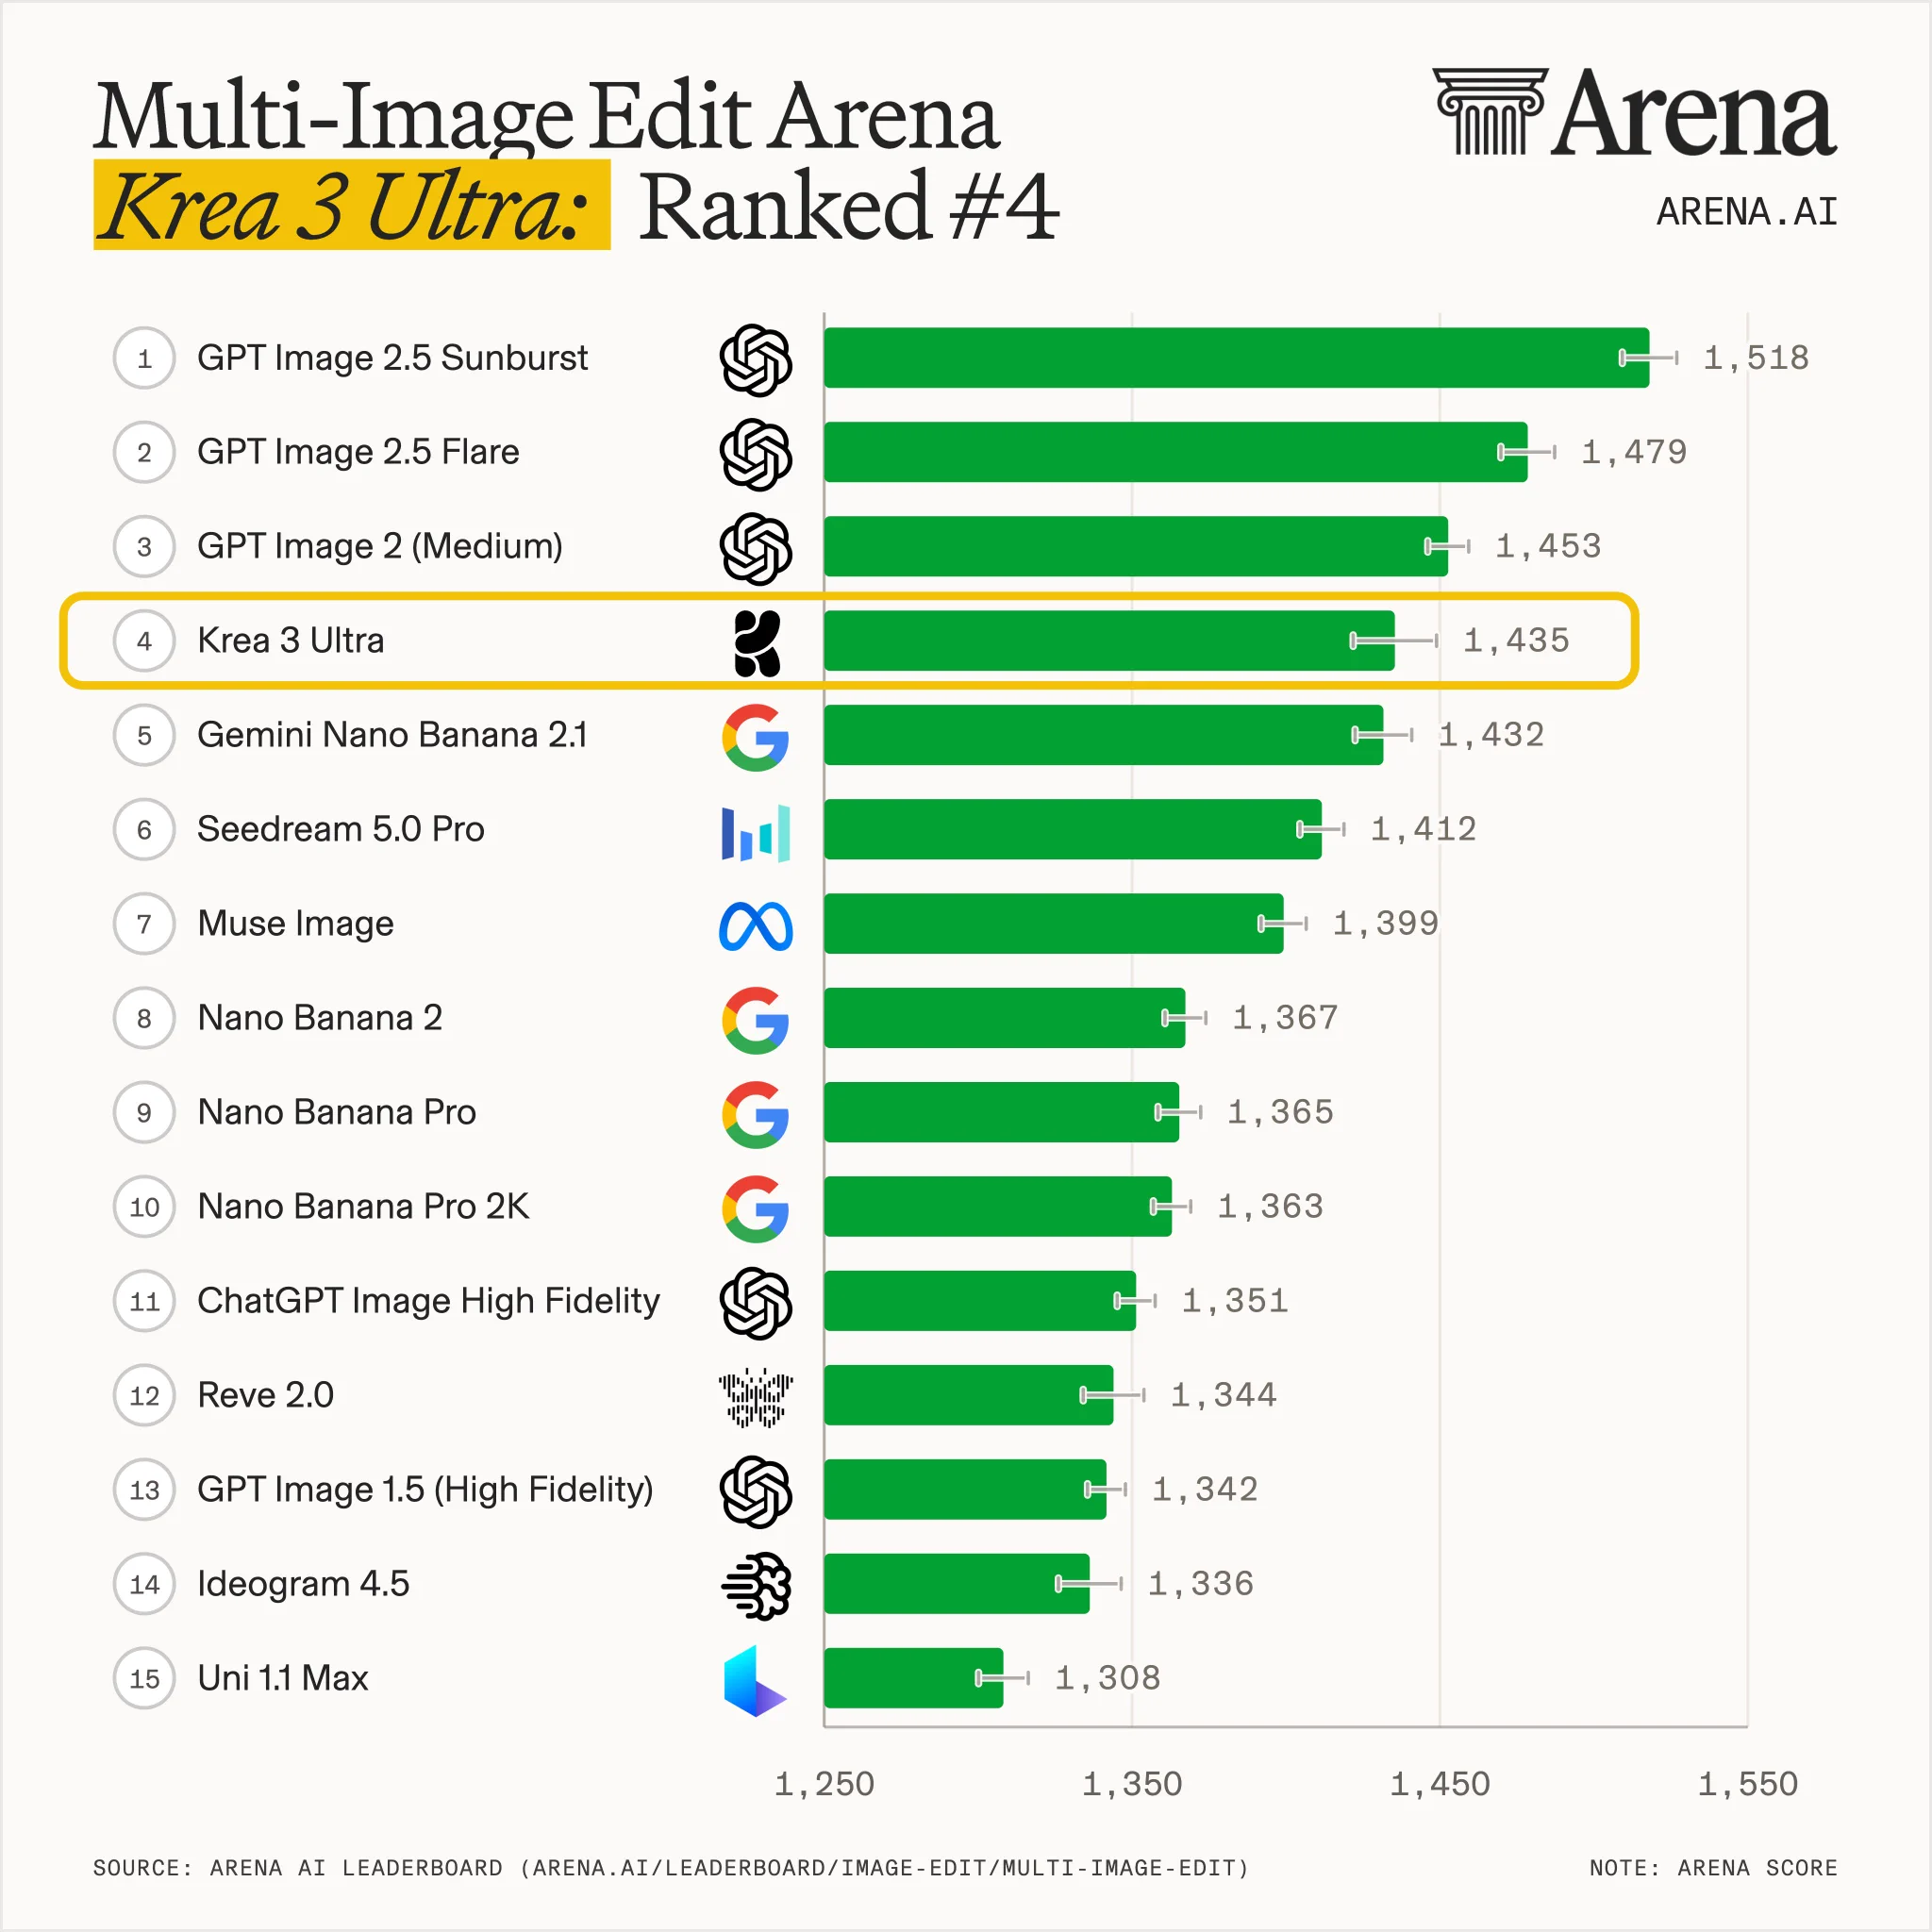
Arena公布Krea 3 Ultra多图编辑1435分、模型第四,单图1411分、模型第八;多图商业设计及3D类别排名第二。
Arena原帖发表于北京时间10月21日00:17。此次更新为独立榜单成绩,不是模型首次发布。Krea 3 Ultra进入Single-Image Edit及Multi-Image Edit两张榜单。
模型名次为多图第四、单图第八;Krea实验室名次为多图第四、单图第五,两种口径不能混用。多图商业设计、3D类别第二,卡通/幻想和文字渲染类别第四,均属于该次Arena评测。
原始来源:Arena ↗
10 / 开发与成本
OpenAI API增加12小时最低缓存选项
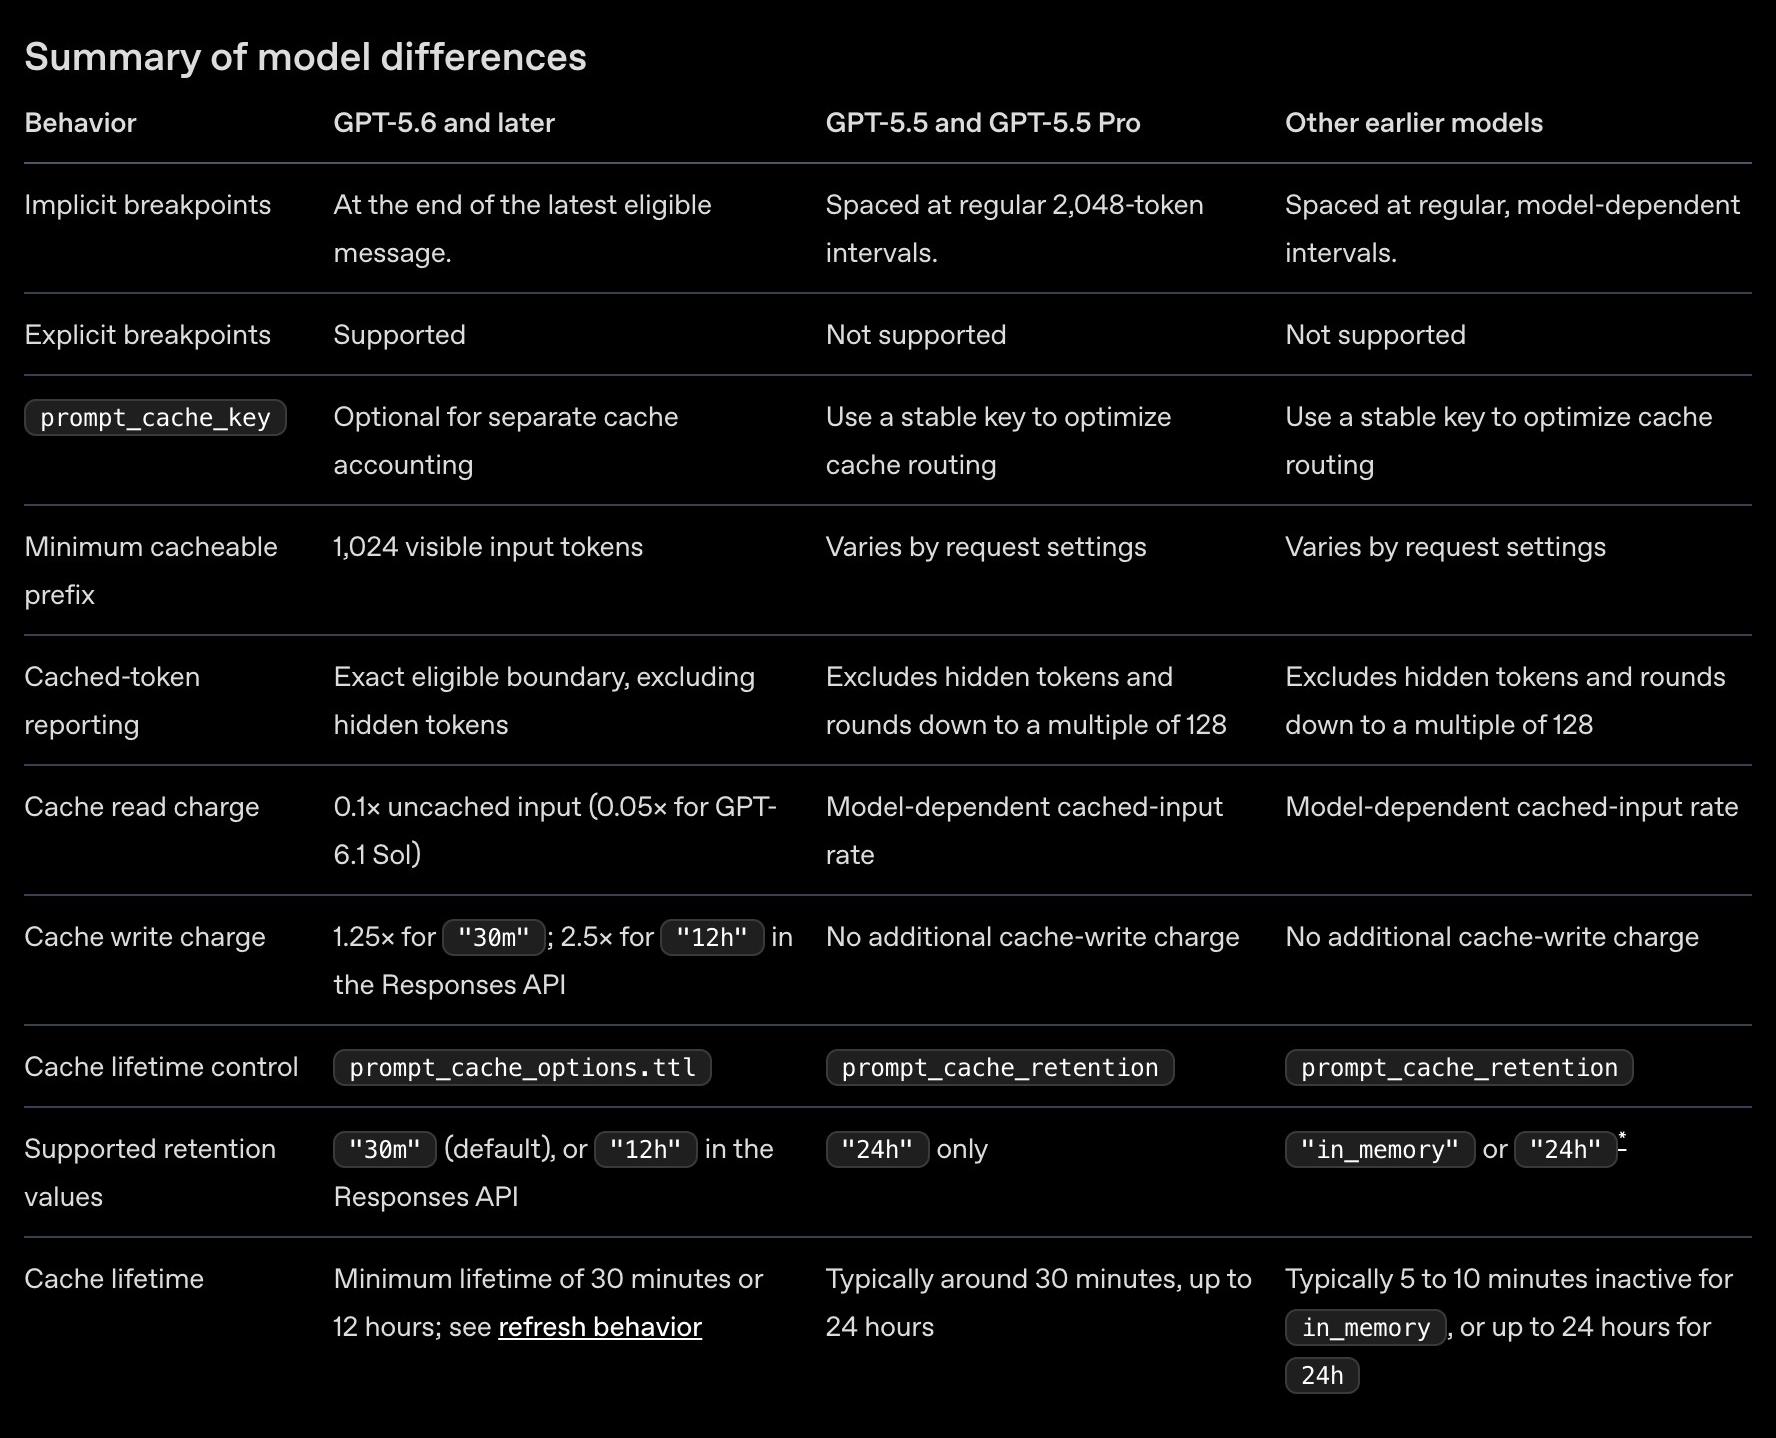
Responses API为GPT-5.6及后续支持模型提供12小时最低缓存寿命,写入总费率为普通输入的2.5倍,读取费率与30分钟方案相同。
官方文档列出30分钟与12小时两种最低缓存寿命。默认30分钟写入总费率为未缓存输入的1.25倍,12小时为2.5倍;这是总费率,不是在普通输入费率上再加收相同倍数。
适合评估同一指令、资料前缀在一天中反复调用的工作流。最低寿命不设定数据删除期限,也不保证每次请求都复用底层计算或降低延迟。实际节省应结合缓存读写量和总账单比较。
原始来源:OpenAI ↗
11 / 行业与公司
OpenAI收购Orchestra Bio研发协作平台
OpenAI宣布已收购Orchestra Bio,将其团队及药物研发协作平台与Rosalind结合,帮助追踪项目、分析任务依赖和排期影响。
10月20日公告称OpenAI已收购Orchestra Bio。Orchestra的平台让科学家、项目负责人和AI智能体共同监控研究与研发活动,OpenAI计划把相关技术与Rosalind结合。
公告举例,一次生产批次失败可能影响临床试验开始时间,智能体可识别受影响活动、收集信息并比较应对方式,再由负责人决定下一步。此次公布的是收购与工作流整合方向,未披露交易金额。
原始来源:OpenAI ↗
12 / 研究与评测
Agent Arena更新成本效果前沿
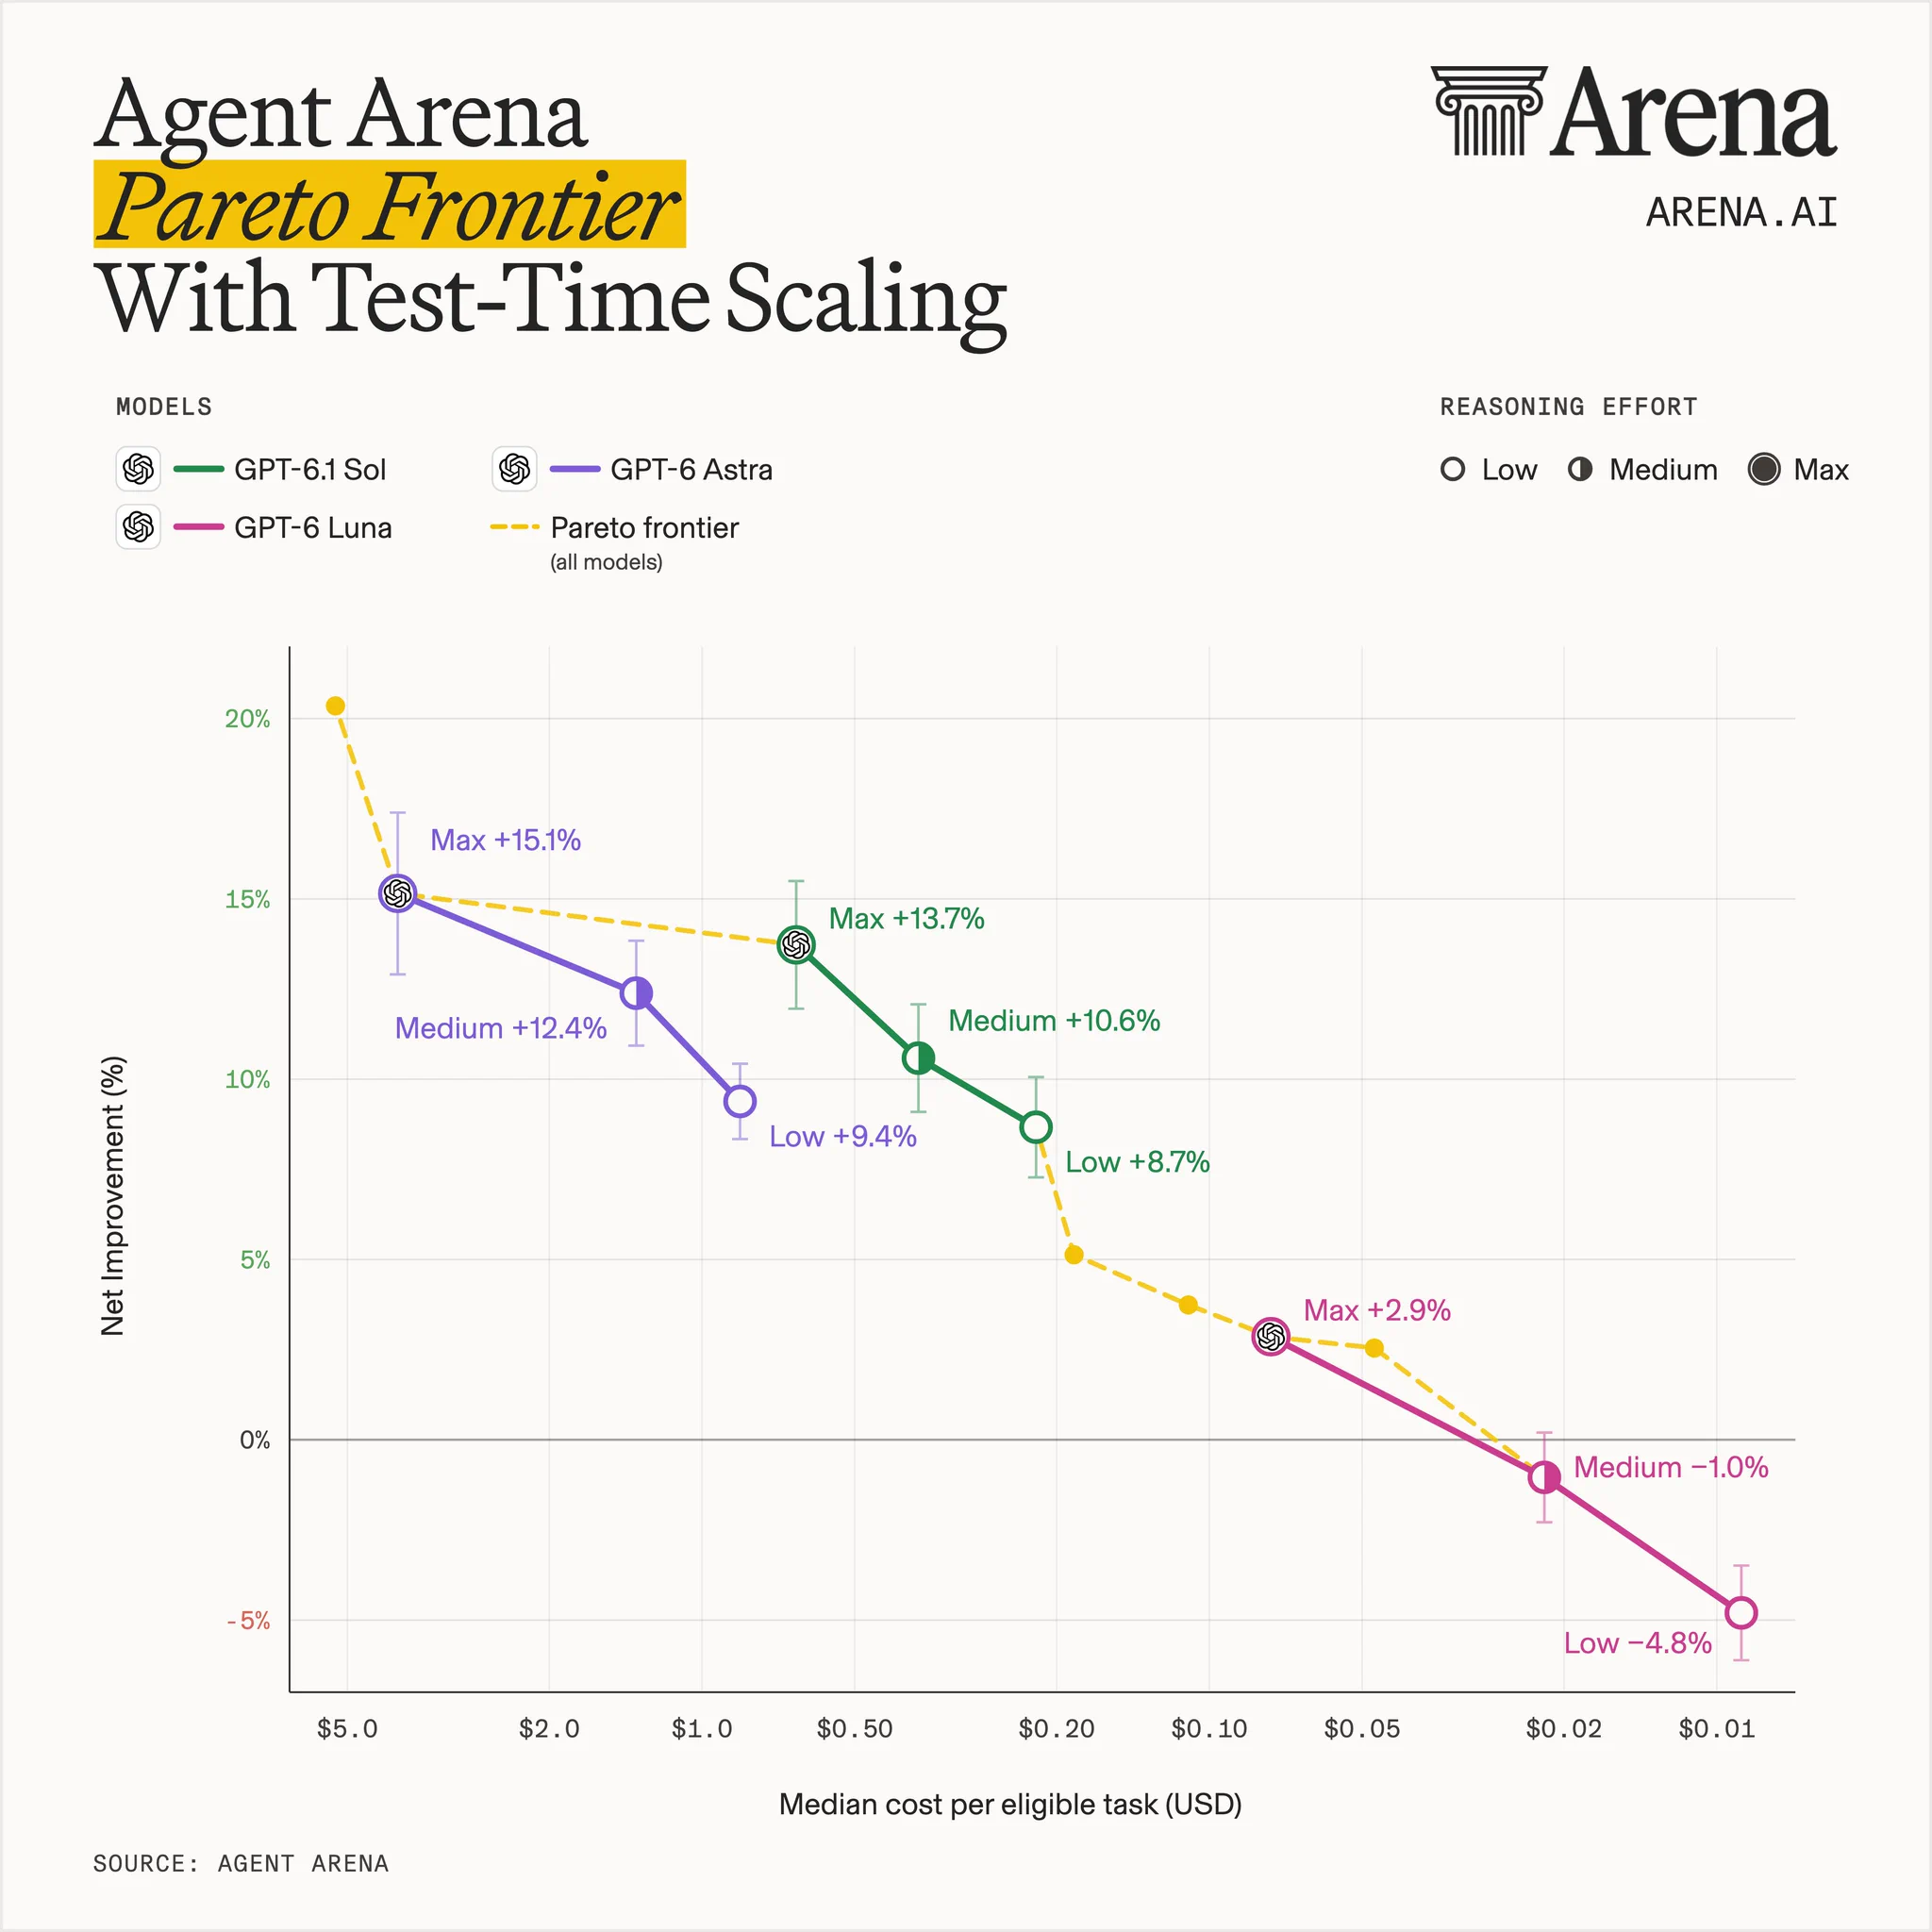
Arena公布GPT-6 Luna与GPT-6.1 Sol不同推理档位占据11个成本效果前沿点中的6个,展示推理强度对成本与表现的影响。
北京时间10月21日01:42发布的原帖显示,Luna在每任务0.10美元以下占四个最优点中的三个,Sol的相关档位位于0.22至0.65美元区间。
统计来自Agent Arena特定任务与推理设置,不等同于全场景最低价格,也不是新模型发布。评估智能体时,可同时比较模型、推理强度、完成效果和实际任务成本。
原始来源:Arena ↗
国内
13 / 开源与本地部署
MiniCPM-V 4.7官方演示iPhone本地推理提速
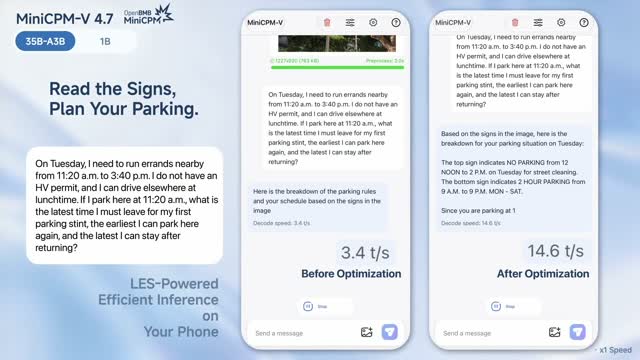
OpenBMB演示MiniCPM-V 4.7的35B多模态模型在12GB iPhone 18 Pro Max本地运行,平均解码20.51词元/秒。
10月20日官方演示称,通过Lookahead Expert Scheduling、专家加载、细粒度量化和DSpark推测解码,同机性能达到未优化SSD专家加载基线的6.07倍。
20.51词元/秒为这台设备的平均解码结果,不与另一条约3GB内存、100词元/秒演示混用。官方同时提供MiniCPM-V代码仓库及相关实现链接,供开发者进一步研究端侧部署。
原始来源:OpenBMB ↗
14 / 常用产品功能
MiniMax Code宣布重新上架App Store
MiniMax Agent官方账号10月20日宣布MiniMax Code回到App Store,用户可核对所在地区商店的实际入口。
官方原帖明确宣布MiniMax Code已回到App Store。此次新信息是应用重新上架。
公告没有列出逐国商店范围、版本号或新增能力,因此不将回归上架扩写成新模型或新功能首发。需要下载的用户可核对所在地区的官方商店页面。
原始来源:MiniMax Agent ↗
15 / 价格与获取
Ollama Cloud限时免费提供MiniMax M3.1 Flash
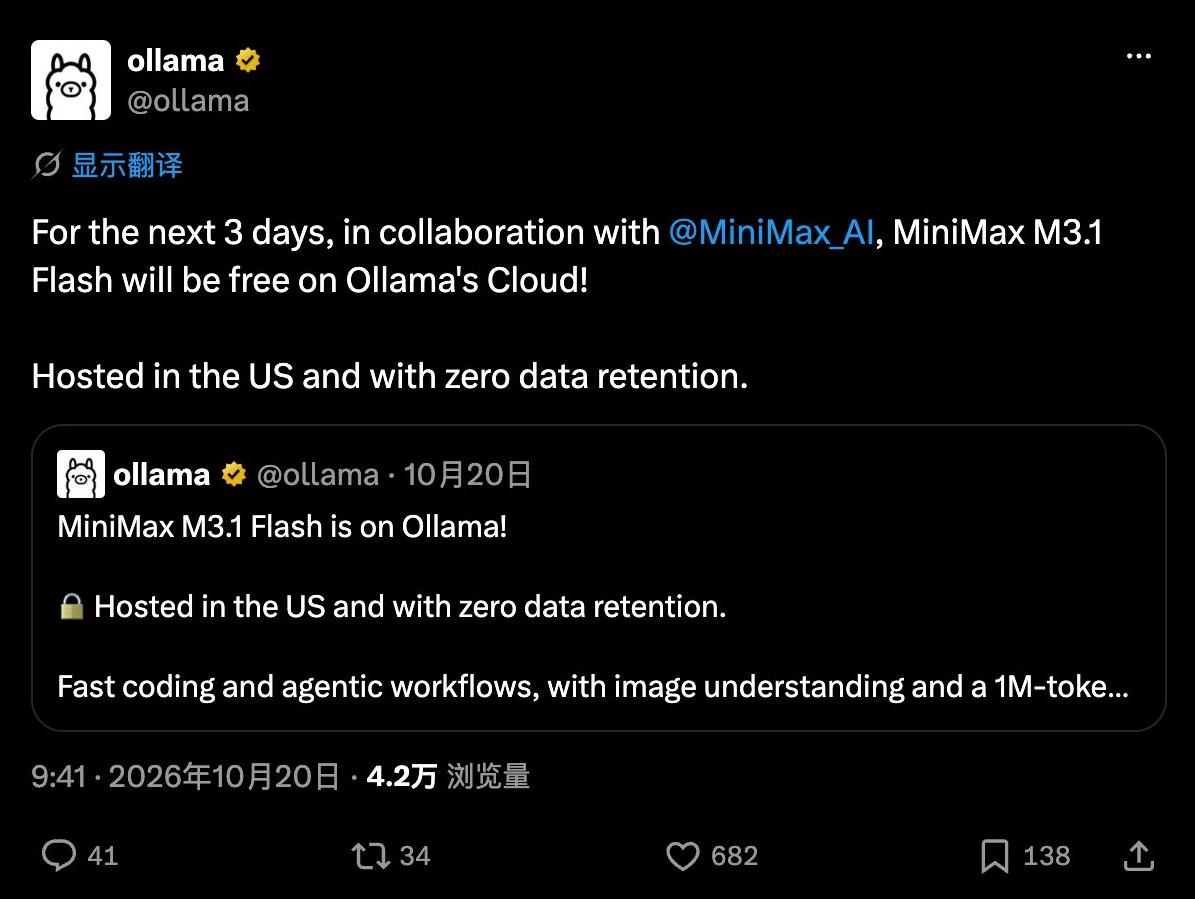
Ollama于10月20日宣布MiniMax M3.1 Flash在Ollama Cloud接下来三天免费,官方称美国托管、零数据留存。
这是Ollama与MiniMax合作的云端活动,原帖指向Ollama Cloud使用方式。服务运行在云端,不等于本机推理或模型权重开放。
公告使用“接下来三天”的表述,未给出精确截止时区。实际使用时应核对入口当前价格和活动状态,不能把限免当作持续免费的承诺。
原始来源:Ollama ↗
16 / 开源与本地部署
Strata 0.2测试版新增独立应用与配置指导
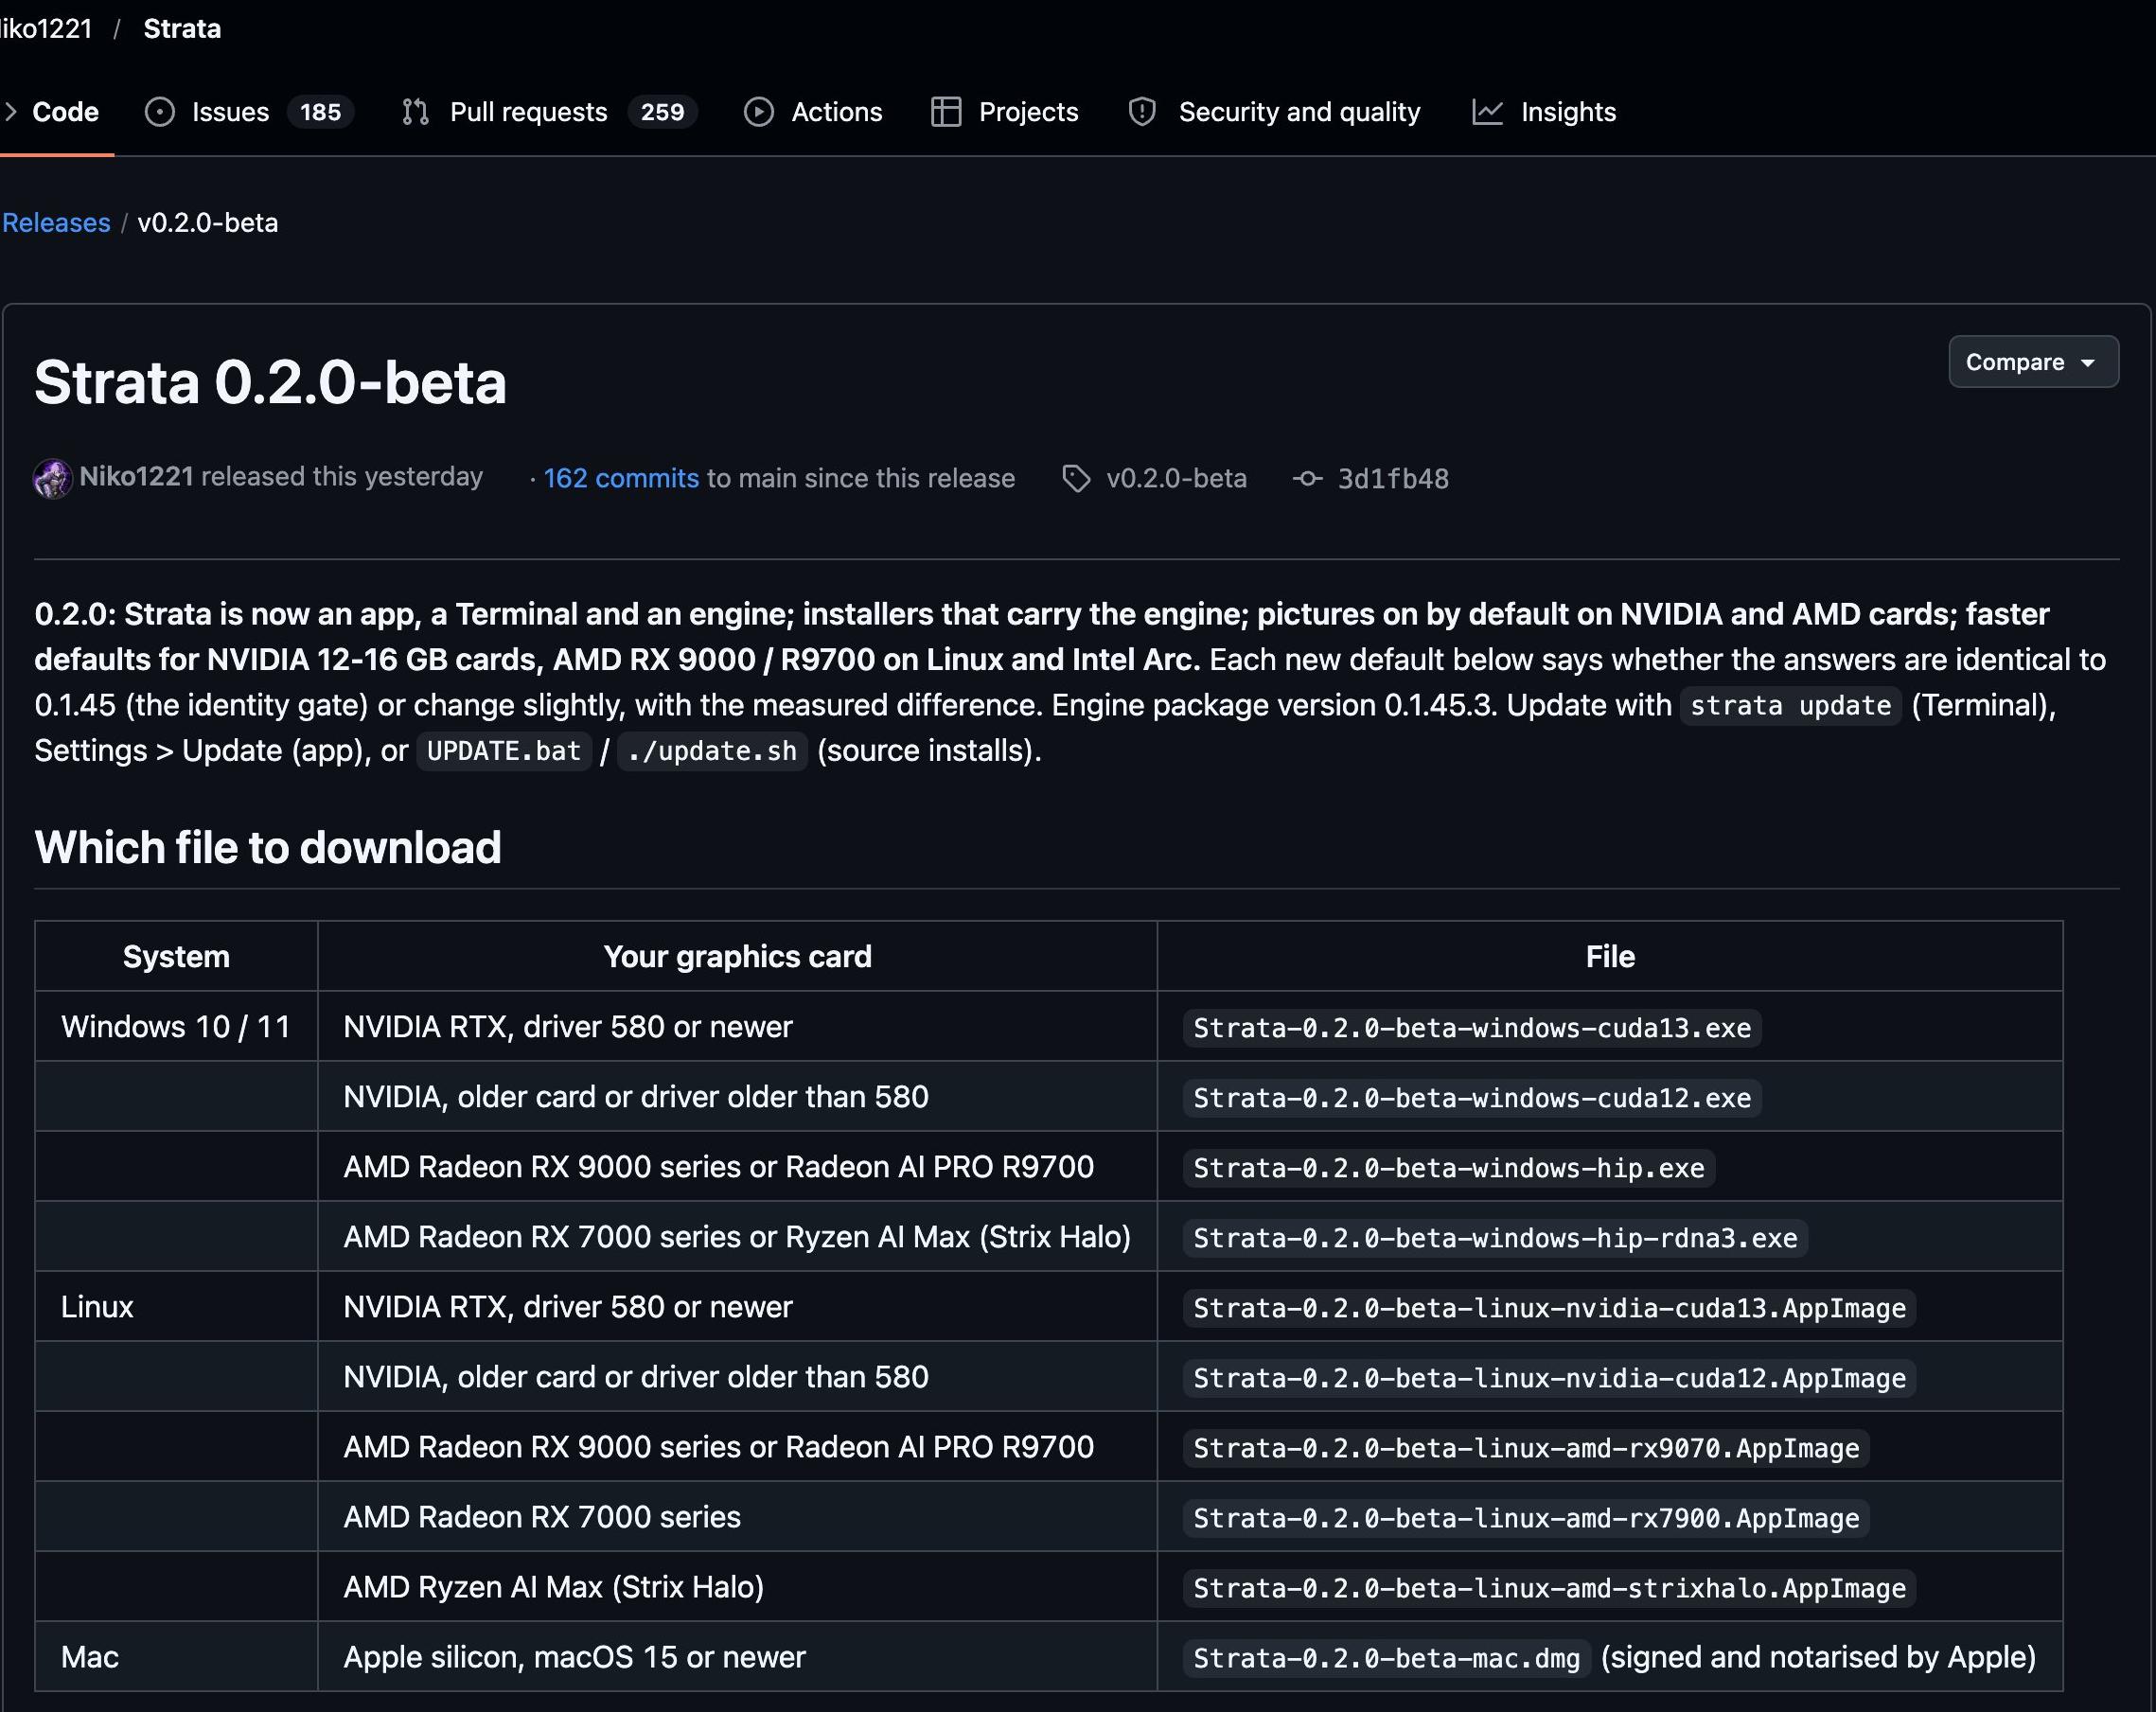
Strata v0.2.0-beta新增独立应用、终端和引擎,并按内存与显存合计容量推荐模型;低内存模式速度较慢。
GitHub记录的发布时间为10月19日13:52 UTC,即北京时间19日21:52。新应用覆盖Windows、Linux和Apple芯片Mac;Mac要求macOS 15以上,目前没有图片理解模块。
官方推荐内存加显存合计40GB的Swift 1.5 IQ2_XS、48GB的IQ3_XXS等档位,较少内存会启用低RAM模式并变慢。媒体所述27.6GB属于Gyro-S档,不等于上述推荐配置。作者报告RTX 3060默认解码从60.36提高至66.52词元/秒,增幅10.2%,性能结果限定于其测试条件。
原始来源:Strata开发者 ↗
稿件由酷恩编辑核验,节目使用AI配音和数字人;原始素材及事实来源逐条列明。
把关注,变成持续的探索。
回看其他期次,或在你习惯的平台继续关注。